







OpenAI 重新造机器人:27个岗位暴露了什么全栈野心?
42号电波©热度: 3712
OpenAI正全面重启机器人业务,通过招聘27个跨领域岗位,构建覆盖数据采集、执行器设计、传感器集成、固件开发、实时控制、供应链管理及现场部署的全栈能力,核心目标是掌控机器人‘身体’以获取真实世界交互数据,驱动AGI模型持续迭代,而非仅提供AI模型。
 摘要由 Mars AI 生成
本摘要由 Mars AI 模型生成,其生成内容的准确性、完整性还处于迭代更新阶段。
如果OpenAI只是想给机器人提供一个更聪明的大模型,它不需要招聘一个齿轮设计工程师,也不需要专门招聘电机电磁设计、执行器测功台、PCB、机器人库存管理、制造工程、EHS、供应链品类经理,以及一名只为机器人业务服务的商业律师。
但截至9月19日,OpenAI官网以「robotics」为关键词可以找到27个职位。今年5月,这个数字还是11个。新增岗位横跨算法、控制、执行器、传感器、固件、数据采集、制造、供应链、安全和现场部署。
甚至在供应链岗位的招聘说明里,OpenAI直接写了一句话:We're a growing hardware company。——我们正在成为一家不断成长的硬件公司。
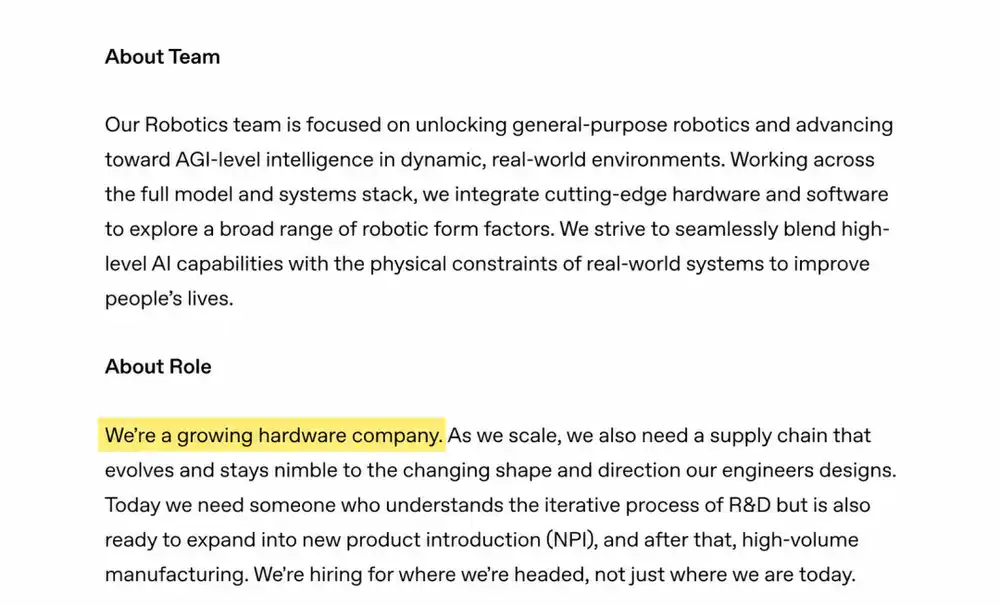
这句话可能比任何一场机器人发布会都更能说明OpenAI正在做什么。
七年前,OpenAI也曾经拥有一支明星机器人团队。Dactyl用Shadow Dexterous Hand在模拟环境里训练,再通过Automatic Domain Randomization把策略迁移到真实世界。2019年,这只机械手已经能够单手转动并解开魔方。OpenAI当时给出的判断是,灵巧操作可能是通往通用机器人的重要路径。
但机器人没有成为OpenAI下一个GPT。
2021年,负责机器人研究的OpenAI联合创始人Wojciech Zaremba确认团队被解散。他当时解释,机器人领域缺少足够的数据,无法像语言模型一样持续扩大训练规模。从AGI研究的投入产出来看,公司决定把资源转向更有希望快速Scaling的方向。
五年以后,OpenAI重新回来了。
只是这一次,它准备解决的恰恰是当年缺掉的东西。
机器人第一次失败,输在数据
Dactyl时代的OpenAI相信,可以把真实世界的大部分复杂性塞进模拟器。
机械手并不需要观察几百万个人类怎样转动方块。研究团队在仿真中不断随机化物理参数,让策略适应不同摩擦、质量、延迟和扰动,再把学到的能力迁移到真实机械手。这是一条非常漂亮的路线,因为真实机器人是昂贵而缓慢的,GPU仿真却可以并行运行。
但它也暴露了机器人与语言模型最根本的差别。
互联网天然存在海量文本和图像,人类过去几十年已经替AI完成了数据生产。机器人面对的却是触觉、关节状态、动作、接触、失败、摩擦和时间同步。很多关键变量根本不会出现在普通互联网视频中。
这也是为什么OpenAI这次公开招聘中,一整套组织直接围绕Robotics Data Acquisition建立起来。
它在招聘负责机器人数据采集的技术项目经理,要求把机器人、传感器、计算设备、操作员界面和数据管线组合成「production-ready」的数据采集系统,并将这些系统扩展到多个站点。另一名数据采集运营经理需要管理工作站、操作员和材料,跟踪利用率、Cycle Time、Throughput、Downtime、Operator Productivity和Data Quality——几乎完全是一套制造工厂的生产指标。
OpenAI甚至已经开始招聘专门维护这套数据生产系统的Field Engineer。
岗位描述里透露的信息很多:OpenAI需要一个「大型、持续运行的真实机器人环境」,其中存在大量已经部署的数据采集工作站,配置不断变化,同时「几乎不能容忍停机」。Field Engineer负责保持这些机器人工作站持续在线,处理机械、电气、控制和软件问题,再把重复故障汇总给研发团队。
这意味着OpenAI正在搭建的可能不是一个普通机器人实验室,而是一座机器人数据工厂。
从这个角度再看2021年的失败,会出现一个很有意思的历史闭环。
第一次OpenAI做机器人,希望尽量用仿真绕过昂贵的真实数据;第二次回来,它首先开始建设的,却是一套规模化生产真实机器人数据的基础设施。
这不是Dactyl 2.0。
OpenAI为什么连齿轮都要自己做?
真正让这次机器人计划显得不同的,是执行器岗位。
如果只是训练机器人模型,OpenAI完全可以购买成熟机械臂、人形机器人或者灵巧手。事实上,它过去几年一直采用这种方式。
2023年,OpenAI Startup Fund领投人形机器人公司1X的2350万美元融资;2024年,它又投资Figure,并与Figure签署协议,共同开发下一代人形机器人AI模型。当时的分工十分清晰:Figure理解机器人硬件,OpenAI提供AI能力。
但这段合作只持续了一年左右。
2025年2月,Figure CEO Brett Adcock宣布结束与OpenAI的合作,把机器人AI全部收回内部开发。他给出的理由恰好击中了机器人行业最核心的争议:要在真实世界大规模解决Embodied AI,机器人AI必须与具体硬件垂直整合,不能把大脑和身体分别外包。随后Figure发布了自己的Helix VLA。
一年多以后,OpenAI自己的招聘页面看起来越来越像是得出了相似结论。
它正在招聘执行器设计工程师,而且不是采购成熟关节。岗位明确要求设计custom robotic actuators,覆盖电机、传动、传感、热设计和结构,并在扭矩密度、带宽、效率、反驱性、转动惯量、可靠性、制造性和成本之间进行系统权衡。除此之外,OpenAI还单独招聘电磁设计和齿轮设计工程师。
更夸张的是,它正在自己建设执行器测功基础设施。
相关岗位需要设计测功机和执行器测试台,用负载电机测量扭矩、速度、效率、温度和耐久性,同时建立电力、传感、DAQ、安全联锁和故障检测系统。另一名机械工程师则负责测试台、夹具、Load Path和防护结构。
这已经超过了「为了理解机器人,做一点硬件原型」的范围。
为什么一家拥有世界级AI模型的公司,要关心齿轮齿形、电机电磁设计和执行器散热?
因为对于机器人来说,身体本身就是模型的一部分。
关节能提供多大的瞬时扭矩,会影响Policy敢不敢快速运动;Backdrivability决定机器人与环境接触时如何响应;传动间隙会改变毫米级操作的误差分布;热衰减决定一套训练策略连续运行两小时以后是否还成立;传感器安装位置和采样频率,又直接决定模型能够看到什么。
语言模型可以相对独立于键盘存在,但机器人模型无法真正独立于执行器存在。
如果模型团队无法改变身体,它最终只能学习适应硬件留下的误差;如果硬件和模型被放到同一个迭代循环里,团队可以反过来修改身体,让下一代模型更容易学。
这大概才是OpenAI向执行器下沉最值得注意的地方。
它争夺的不只是机器人硬件利润,而是训练分布本身的控制权。
从相机到安全控制器,OpenAI准备把控制链一起拿走
执行器之外,OpenAI也在补齐传感和实时控制。
传感器项目经理的岗位覆盖Camera、LiDAR、IMU、Radar、Proximity Sensor和Audio,并且要求从设计、集成、测试一路推进到BOM准备、供应链和生产发布。
Firmware Engineer的描述更加直接。这个岗位要定义机器人嵌入式系统,包括实时运行、设备Bring-up、硬件接口、Fault Handling、Safety Mechanism和生产准备。OpenAI还特别要求设计Watchdog、冗余、故障恢复和Safe-state,并透露机器人嵌入式栈大量使用Rust。
Control Systems Engineer则负责实时系统、执行器、动力学和低层硬件交互,要直接在机器人上调试和验证整机行为。
这几类岗位共同勾勒出了一条完整控制链:
传感器→实时固件→低层控制→执行器→机器人运动。
换句话说,OpenAI并没有准备让GPT之类的大模型直接以几十赫兹控制电机。相反,它在建立机器人行业已经越来越明确的分层体系:高层模型负责理解任务、规划和泛化,低层实时系统负责动力学、安全和快速反馈。
真正值得观察的是,这两层是否会共同训练。
如果高层模型能够读取更加丰富的低层状态,而低层控制器又能够根据模型的任务上下文动态调整,那么OpenAI最终拥有的就不只是一个「机器人用GPT」,而是一套从Language Reasoning一路延伸到Torque Output的完整系统。
最值得警惕的岗位,其实是供应链经理
算法和执行器还能被解释成研究。
供应链很难。
OpenAI的机器人Technical Commodity Manager招聘描述几乎把它下一阶段的路线图直接写了出来。
公司称自己是「一家正在成长的硬件公司」,目前需要建立适合研发迭代的供应链;下一步进入NPI,也就是新产品导入;再下一步则是high-volume manufacturing,大规模制造。
这个岗位未来还要帮助建立完整供应链团队,包括Buyer、Global Supply Manager和Contract Manufacturing负责人,采购类别明确列出了精密机加工、齿轮和机械件、EMS/PCBA、电气元件,以及Contract/JDM Manufacturing。
从原型供应商迁移到量产供应商、做DFM、首件检验、Pilot Build、供应商质量和单一来源风险管理——这些事情与训练机器人模型几乎没有关系,却是任何一家准备真正制造硬件的公司最终都必须经历的过程。
今年早些时候,OpenAI面向美国制造业发布供应链RFP时,也已经把「advanced robotics所需的gearboxes、motors和power electronics」列为希望强化的关键产业输入。
因此,这27个职位里真正值得关注的,不是又多了几个ML Engineer。
而是OpenAI开始为机器人建立从样机到量产之间的组织能力。
数据、供应链以后,是现场
甚至这还不是终点。
OpenAI同时招聘机器人Lead Safety Engineer,要从研发最早期就参与产品架构,并负责监管策略和产品安全;它还设置Senior Manager EHS岗位,处理真实硬件研发和生产环境中的健康、安全与环境问题。机器人商业律师则需要处理供应商、制造、采购、许可和战略合作协议,并明确提到「commercialization of next-generation robotics systems」。
这些岗位的重要性在于,它们通常出现在一个硬件项目从研究走向产品以后。
实验室里的机器人可以随时急停、拆开、重新刷固件;真正进入工厂、数据中心甚至家庭的机器人,却要面对责任事故、供应商协议、隐私、产品责任、认证和售后。
OpenAI自己的机器人岗位描述也已经给出了一条非常明确的产品顺序。
短期,它希望制造能够帮助熟练工人「建设未来基础设施」的机器人;长期愿景则是让每个人拥有一台可以完成各种任务的Personal Robot。Business Insider进一步报道称,OpenAI早期关注的应用包括数据中心,而团队由DALL·E和Sora核心人物Aditya Ramesh领导。OpenAI并未公布正式机器人产品或上市时间。
如果把这条路线放回OpenAI自身的现实需求,它很合理。
OpenAI正在以前所未有的规模建设AI基础设施。数据中心、机电设备、服务器部署、运维、供应链和制造都需要大量熟练劳动,而且环境相对结构化、任务价值高、公司自己又能够控制场景。
这可能比一开始就让机器人去普通家庭洗衣服,容易得多。
更重要的是,如果OpenAI自己就是第一批客户,它可以同时拥有三样东西:机器人、任务,以及Rollout Data。
这正是机器人闭环最难从外部合作中获得的东西。
OpenAI真正想拿回来的,是身体产生的数据
GPT-6真正带给机器人行业的冲击,不只是「又多了一个可以控制机器人的模型」。
RoboCurve的实验已经划出了一条很清楚的边界:抓放积木,GPT-6 Astra完成了19/20次;但到了需要精确接触和插入的拼图任务,只完成2/20次。
这意味着,视觉理解、空间推理、任务拆解和粗粒度动作规划,正在越来越快地变成通用模型的基础能力;真正困难的部分,则继续向接触、力控、实时反馈和执行器下沉。
对于机器人行业,这会直接重写价值分配。
VLA公司需要证明,为什么客户不能直接用GPT-6负责高层理解,再调用一个更小、更快的专用Policy;本体公司也不能再只靠「机器人会开冰箱、整理物品」这样的Demo证明AI壁垒。通用模型越强,行业越会追问成功率、人工接管、连续运行、异常恢复和真实生产小时。
而那些过去被大模型叙事遮住的东西——触觉、执行器、低层控制和真实交互数据——反而会重新变贵。
这也解释了OpenAI为什么开始自己设计执行器。
从1X到Figure,OpenAI过去采取的是典型基础模型公司的方式:让别人造身体、进入现场,自己提供智能。但如果未来机器人模型真的遵循Scaling Law,最稀缺的资产可能并不是某一代本体,而是机器人每天在真实环境里产生的交互数据。
而数据从来不是独立产生的。
自由度决定机器人能做什么,传感器决定它能看到什么,执行器决定什么动作可以稳定重复,控制器决定一次失败留下多少信息。
谁定义身体,谁就在相当程度上定义数据集。
如果OpenAI永远只提供GPT-6,它可能拥有最强的高层模型,却未必拥有最稀缺的真实世界数据。本体厂商控制身体,部署公司控制客户,真正高价值的失败、接触和Rollout数据都会沉淀在别人的系统里。
Figure最终转向自研Helix,只是这种矛盾最直接的一个案例。
所以OpenAI现在从模型一路向执行器、固件、控制、数据采集和现场部署下沉,并不只是为了造一台机器人。
它是在争夺机器人下一轮Scaling真正需要的东西:
身体→数据→模型→部署→更多数据。
GPT-6越强,这个趋势反而越明显。
因为当通用模型越来越会「想」,机器人行业真正稀缺的能力,就会越来越集中到它如何感知接触、如何稳定行动,以及如何把每一次真实世界的失败重新变成下一次模型进步。
2019年的OpenAI想证明,一个足够好的算法,可以让一只普通机械手学会前所未有的能力。
2026年的OpenAI,开始重新设计那只手。
通用机器人最终或许需要一个通用大脑,但下一条真正的Scaling Law,很可能要从大脑一直写到身体,再从身体写回数据。
本文来自微信公众号: 42号电波 ,作者:小波,编辑:大吉,原文标题:《OpenAI 重新造机器人:27 个岗位暴露了什么全栈野心?》
本内容旨在传递行业动态,不构成投资建议或承诺。


24H热门新闻
暂无内容
