







王超给超节点画了一条线
王智远热度: 4551
阿里云王超在云栖大会提出超节点的核心标准是系统语义连续性,强调编程模式不变、内存统一寻址、确定性低时延、无收敛互联和全栈闭环,指出64张M890卡是当前模型规模与拓扑性能的最优解,并批判行业过度关注卡数而忽视系统级设计。
 摘要由 Mars AI 生成
本摘要由 Mars AI 模型生成,其生成内容的准确性、完整性还处于迭代更新阶段。
阿里云加速计算产品和技术负责人王超,在云栖大会平头哥算力峰会上放了个炮。他说,市面上大部分超节点,都是假的。
卡不够多吗?当然不是。问题在于,大家对超节点的理解,从一开始就跑偏了。
王超,在内部给超节点起过不少英文名,Super Node 太直译,后来还想过一个叫 Mega Node 的。但名字不重要。
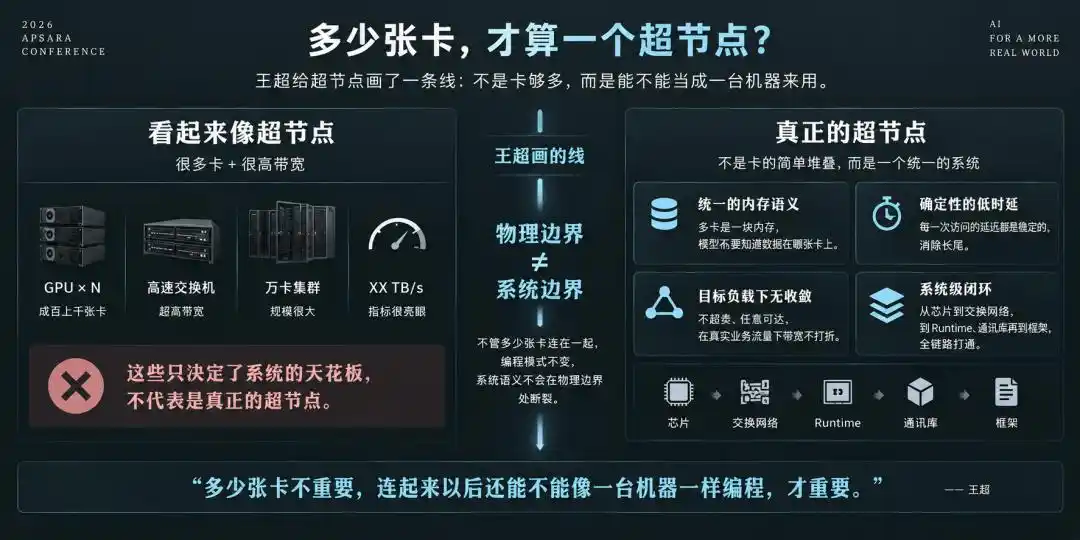
但关键是,他给超节点画了一条线,超节点里面,所有的编程模式不变,系统的语义不会在物理边界处断裂。
翻译成人话,不管你多少张卡连在一起,写代码的方式和只有一张卡时完全一样,数据存在哪张卡上,你不用管,系统帮你搞定。
这才是判断真假超节点的那条线。
跟卡数没关系,跟规模没关系,这条线守住了,就是真的,守不住,多少张卡堆在一起,也是一群各自为政的孤岛。
但现实呢?行业特别容易掉进数卡数的坑。
发布会上一堆人在讲,我们有万卡集群,带宽多少多少 T。王超说,带宽和速率这些东西,顶多定义了系统的天花板,但能不能摸到天花板,取决于另外四样东西。
哪四样?
统一的内存语义,确定性的低时延,目标负载下无收敛的互联,还有系统级的闭环。
这四样东西嘛,大部分发布会从来不提,也没法一句话讲清楚,得把整个系统拆开来说。
什么叫统一的内存语义? 64 张卡的内存地址空间对模型来说是一整块,它不需要知道数据具体在哪张卡上。
什么叫确定性的低时延?
每一次访问的延迟都是稳定的,不会偶尔快偶尔慢;目标负载下无收敛,换句话说,在你真正跑的业务流量下,带宽不会打折。
系统级闭环,从硬件到软件全链路打通,各层都得配合上。
王超自己拆了。他给了一个五层分析法,从下往上看 Scale up 路线。
最底层电信号和介质,PHY 和光纤,管物理链路这一层。往上,链路层,流控、验错、恢复怎么完成。再往上是报文层,数据包怎么穿过整个交换网络。最上面是事务层,事情怎样保证顺序并且正确完成。
底下三层出问题,顶多重传、降速,体感上卡一下。事务层出问题,性质就变了,那是系统级故障。
他说为了准备这些数字,用 Agent 翻了 40 多篇论文,每一个指标都有论文出处。
大部分发布会只说最底下那层,我带宽多大,我速率多高,王超说,PHY 的相似性不代表事务语义、传输可靠性和交换能力的相同性。
你物理层长得像,不代表上面几层也是一回事。
关键就在最上面那层:事务。
远端内存访问一旦进入关键路径,任何丢包、错包、长时间拥塞,性质就变了;那已经是系统问题了,会造成 memory fail(内存检测失败),memory fail 意味着系统 crash(非正常终止)。
这和正常网络丢包重传完全不一样,你在手机上刷视频丢个包,重传就是了,体感上卡一下,不影响什么,但在超节点里,一次丢包就可能让整个系统挂掉。这个性质完全不同。
所以,你看,超节点不是买最快的芯片加最快的交换机就能攒出来的,它要从芯片到交换网络、到运行时到通讯库到框架,一整套闭环设计。少一层都不行。
有意思的是,王超自己的身份是平头哥芯片最大的内部用户。
他管阿里云的 GPU 业务,日常用的恰好是平头哥的卡,他说过,跟平头哥关系很好,因为他正是他们最大的客户。
所以,他看这个问题,天然站在使用者这边。他关心的只有一件事,这些卡连在一起,到底能不能当一个系统来用。
......
堆卡解决不了问题。那到底需要多少张卡连在一起,才算一个真正的超节点?
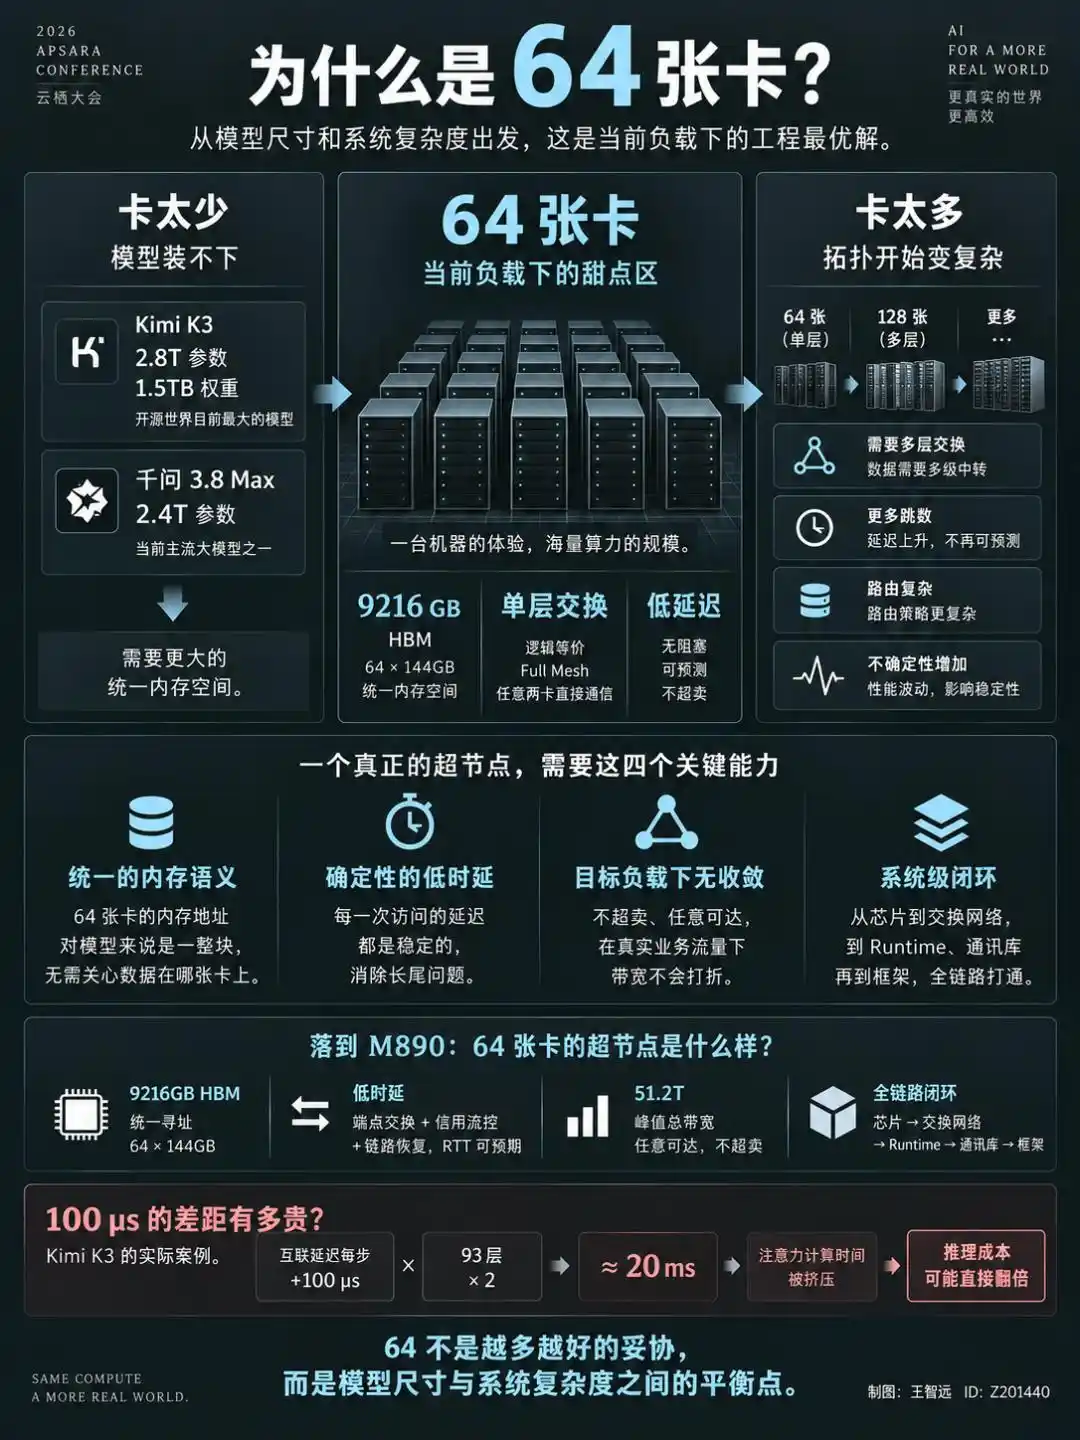
王超给了个数字,64 张。这个 64 直接从负载反推出来的。
工程嘛,讲究实现同样目标时多快好省。先看你手里有哪些活。
这两个模型,64 张 M890 完全装得下。每张 M890 配 144GB HBM,64 张合起来 9216GB。
模型尺寸继续往 5T 甚至 10T 走呢?也能装,支持 MFX 和 FP4 量化。王超自己也承认,到 10T 有点勉为其难,但眼下够用。
他管这个叫甜点。
现在主流模型的尺寸,恰好落在 64 张卡的舒适区里,成本、稳定性、模型尺寸三者之间,找到了一个难得的平衡点。
M890 物理上能支持到 128 张卡,但王超选了 64,因为过了 64 就得两层交换,单层满血就保不住了,能装 128 和该装 64 是两码事,工程讲刚好够用且拓扑最优。多不见得好,合适才叫好。
但装得下也就一半。还有一半,这 64 张卡怎么连。
卡跟卡之间的连接必须足够干净,64 张卡做单层交换,逻辑上等价于 full mesh。
通俗讲,任意两张卡之间都能直接对话,不用中间人传话;无阻塞,无收敛,无带宽超卖,任意可达,意味着任意两张卡之间的延迟完全可预测。
一旦超过 64 张卡,单层交换不够用了,得上多层。
多层意味着数据包从 A 到 B 中间要经过好几个节点接力,好比寄快递不能直达,得经好几个中转站分拣。
Clos 网络、Dragonfly 拓扑,都是这个思路,跳转一多,延迟上去了,路由策略复杂了,不确定性也来了。这些东西在超节点里全是致命伤。
来看看其他家怎么选的?
英伟达 Vera Ruby,576 张卡,第一层 cross bar(交换机内部直连),第二层 Dragonfly(多机柜间网格互联)。
华为新一代节点,机内 3D Torus(三维环面拓扑,数据在三个维度上传递)加一层 cross。Google 继续走 3D Torus。
王超自己的判断:同一个 UALink 标准定义,不代表做出来的产品一致,拓扑和软件实现方式不同的时候,性能完全不同。
标准一样,东西可以完全不一样,这句话信息量挺大的。换句话说,超节点这道题,没有标准答案,全看各家怎么解。
说回 64 张卡。这个数字的本质,其实在负载和拓扑之间找最优解,卡太少,模型装不下。卡太多,拓扑退化,语义连续性守不住。
64 张卡刚好卡在这个区间,当前主流模型装得下,单层交换又保证了连接满血。
落到 M890 上,数字是这样的,PPU 芯片加 ICN Switch 1.0 构建远端内存访问,64 卡 9216GB HBM 统一寻址。
端点交换加信用流控加链路恢复,RTT 完全可预期,长尾消除;域内 51.2T 峰值总带宽,任意可达,不超卖。从芯片到交换网络到 runtime 到通讯库到框架,全链路闭环。
这四个指标放在一起看,才是一个超节点该有的样子。
而且别忘了,指标最终要服务于真实业务流量。推理场景对延迟极其敏感,每多一微秒的互联延迟,乘以几十层网络,累积起来全是真金白银的成本。
超节点建好了,最终得看模型跑起来怎么样。
李伟良在峰会上透露,V900 明年 Q1 推出,端到端性能提升 3 倍。等 V900 进入超节点,64 张卡的算力底座会再上一个台阶。但方法论不会变,关键还是系统语义的连续性。
......
2.8T 参数,1.5TB 权重,解码阶段每一步只有 100 毫秒的预算;这 100 毫秒里,注意力计算要吃掉大约 50 毫秒,混合专家权重读取再吃掉大约 50 毫秒。留给互联和其他操作的余量非常小。
访存能力弱一倍,成本增加不是翻倍,是从能跑 100 条请求变成跑 0 条,一百倍的差距,在超节点里,任何一环拉胯,代价都是成倍放的。
K3 已经在 M890 上适配上线了,兼容性做得不错。
徐欣然说,所有平台里,只有两家可以做到比较小损耗。他还补了一句,K3 对芯片的要求非常全面,每个方向都不能差,任何一个短板都会被放大。
这算是来自模型方的实际验证了,也是对超节点整体设计能力的检验。
圆桌环节聊到最大的痛点,王超说,算力不够。他的判断挺有意思,第一性原理来看,硅本身不贵,贵的是产能。
他认为未来几年半导体产能需要扩大一千倍,不过五到十年后会出现产能过剩,但眼下,每一分效率都抠得很紧。
说白了,超节点存在的意义,无非是在产能还不够的日子里,把每一颗芯片的能力榨干净。
行业里还有个误解得澄清一下。
有人觉得,芯片不行靠超节点来补。王超认为,这个逻辑不科学。超节点和芯片能力是两回事,得并行发展,拿超节点补芯片短板,补不上。
单机扩展和分布式扩展没有任何对立性,没有谁比谁高端,看场景,看成本。
回过头看整条链路:
超节点的关键在系统语义连续性。64 张卡是当前负载和拓扑交叉下的最优解;到了这里,答案更清楚了,超节点最终要交给模型用,模型跑得好不好,才是检验超节点的唯一标准。
同场峰会上,平头哥半导体副总裁李伟良说过一句话:
真武是系统,不只是芯片。
到了超节点这一层,这句话有了下半句,系统连起来了,才算真正开始工作。嗯,王超关心的那件事,这些卡连在一起到底能不能当一个系统来用,答案正在被越来越多的模型验证。
本文来自微信公众号 “王智远”(ID:Z201440),作者:王智远
本内容旨在传递行业动态,不构成投资建议或承诺。


24H热门新闻
暂无内容
