







MiMo-V2.6刚发,小米罗福莉扔出MiMo-V3新架构,引用DeepSeek多项成果
智东西热度: 3619
小米MiMo大模型团队负责人罗福莉提前披露MiMo-V3核心架构HySparse2,该架构通过两级KV共享和Token级稀疏选择,显著降低长上下文下的Prefill计算量(降至Hybrid SWA的约1/5)和KV Cache占用(降至约1/4.5),并提升Agent多轮任务中的长上下文检索准确率。
 摘要由 Mars AI 生成
本摘要由 Mars AI 模型生成,其生成内容的准确性、完整性还处于迭代更新阶段。
智东西9月24日报道,昨晚,小米MiMo大模型负责人罗福莉发文,提前披露了MiMo-V3的新架构,其核心组件HySparse2率先登场,相关技术论文同步公布。
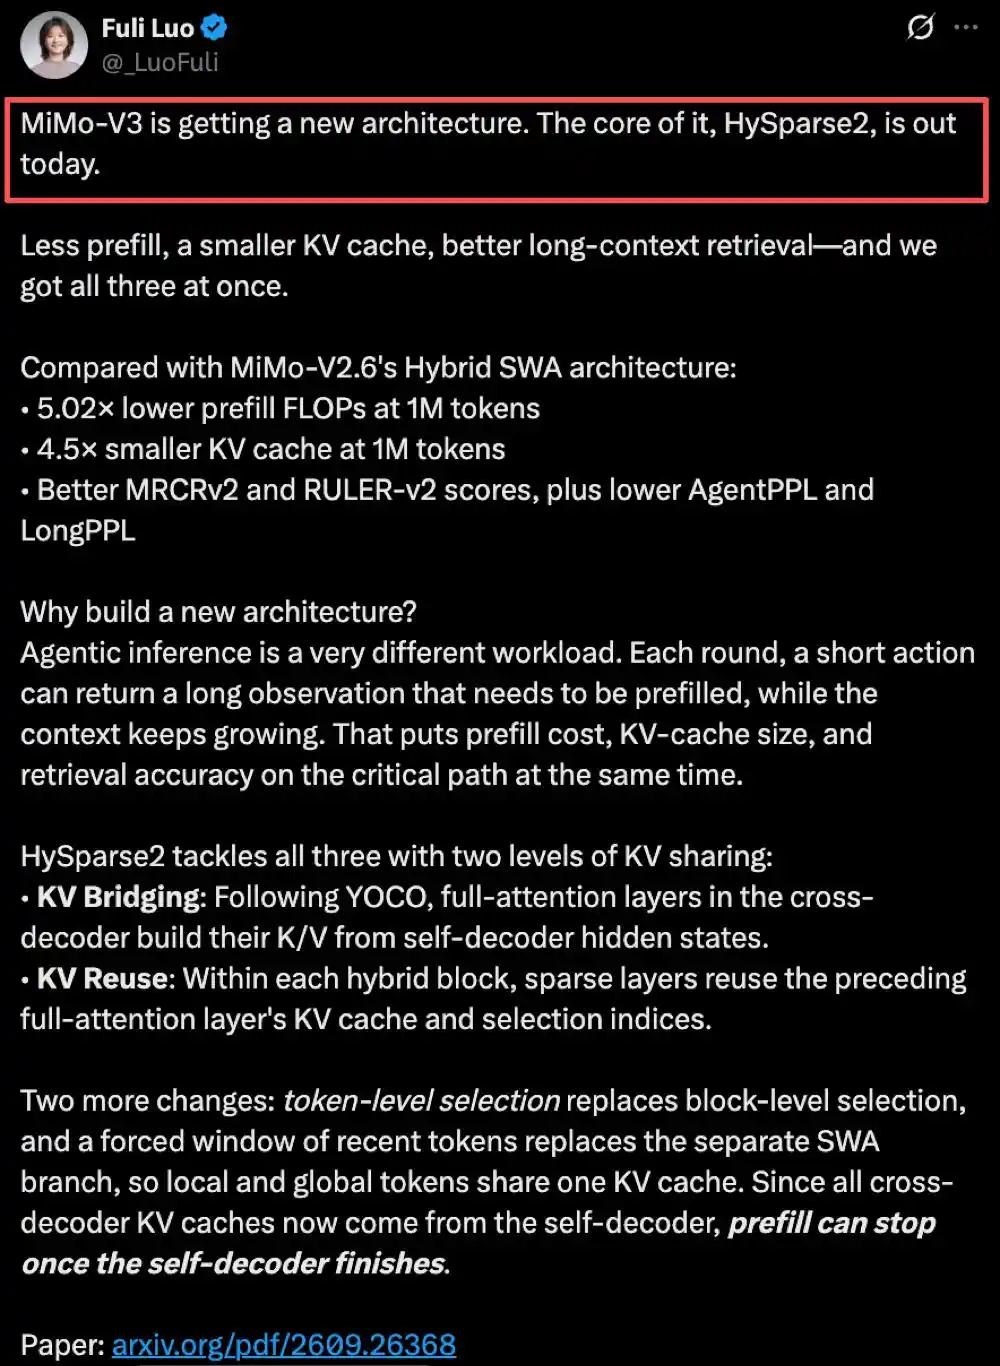
▲罗福莉发文
简单来说,这套新架构主要解决Agent越做越多轮之后出现的三个问题:长输入算得太多、缓存占得太大,以及如何从越来越长的上下文里准确找到需要的信息。
罗福莉直接给出了一组数据:与MiMo-V2.6采用的Hybrid SWA架构相比,在100万Token上下文下,HySparse2处理长输入时所需的预填充(Prefill)计算量降至约1/5,KV Cache占用降至约1/4.5;与此同时,其长上下文检索表现进一步提升,AgentPPL和LongPPL也有所下降。
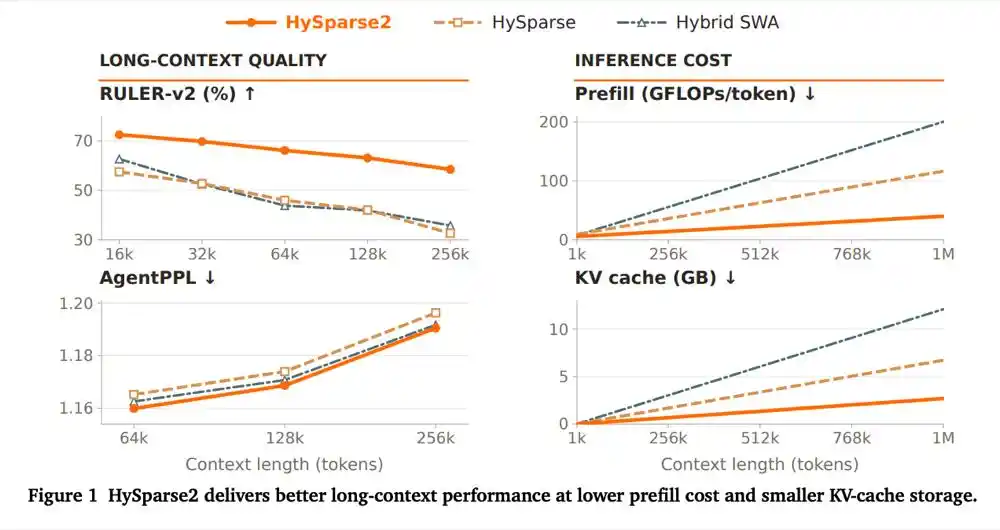
▲HySparse2在长上下文表现、Prefill计算量和KV Cache占用上的对比
HySparse2论文由小米LLM-Core团队完成,共有15位作者,罗福莉为通讯作者并标注为Team Lead。论文参考文献里还出现了不少业内熟悉的成果。
其中,
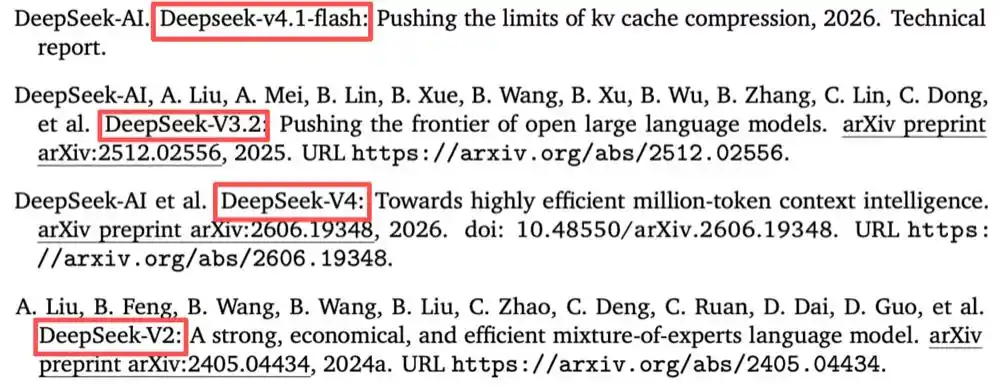
▲HySparse2论文引用的4项
值得注意的是,距离小米上一轮模型更新,才过去两天。
9月22日,小米大模型团队刚刚发布并开源新一代Xiaomi MiMo-V2.6系列,并预告后续将逐步开放MiMo-V2.6-Pro-UltraSpeed。相比MiMo-V2.6-Pro,后者在同等智力水平下输出速度提高20倍。
小米还同步开源了用于新模型训练的RL环境、框架以及模型技术报告。罗福莉当时称,MiMo-V2.6押注大规模RL扩展,进行了开源模型迄今最大规模的单次RL训练,团队将其视为探索RSI(递归自我改进)、通往AGI的新一步。
MiMo-V2.6刚刚把大规模RL摆到台前,这一次,小米把刀落到了模型底层架构上。
01.
Agent多轮任务
带来更高的长输入成本
HySparse2解决的问题,与Agent越来越典型的一种工作模式有关:模型生成的动作很短,工具返回的内容却可能很长。
例如,Agent可能只生成一句搜索指令或一次工具调用,随后搜索引擎返回一篇长文档,代码工具返回大量运行日志。模型进行下一轮推理之前,需要先把这些新增内容处理一遍。
这个过程就是Prefill,也就是预填充。
当Agent连续调用搜索、代码执行、文件读取等工具,文档、网页和运行记录会不断进入上下文。模型既要反复处理这些新增输入,还要保存越来越大的KV Cache,并在几十万甚至上百万Token的历史信息中找出当前真正需要的内容。
论文因此把长周期Agent推理面临的问题归纳为三个方面:降低Prefill计算量、减少KV Cache占用,以及提高长上下文检索准确率。
上一代HySparse已经做过一轮优化。它把全注意力层和稀疏注意力层交替排列,后面的稀疏层可以复用前一个全注意力层生成的KV Cache和选择索引,从而减少注意力计算和缓存占用。不过,在Prefill阶段,HySparse仍需要依次执行全部网络层。
到了HySparse2,小米进一步把Prefill的执行路径缩短:处理长输入时,模型跑完前半部分,就可以完成后续推理所需KV Cache的构建。
02.
两级KV共享
让模型少跑一半
实现这一点的核心,是HySparse2采用的两级KV共享。
第一层叫KV Bridging。
HySparse2把模型主体分成Self-Decoder和Cross-Decoder两部分。前者由全注意力和滑动窗口注意力组成,后者则由全注意力和稀疏注意力组成。
在Cross-Decoder中,全注意力层生成K和V时,可以直接使用Self-Decoder对应全注意力层产生的隐藏状态。这样,后半部分无需再完整处理一次此前输入的全部Token。
第二层是KV Reuse。
进入Cross-Decoder后,一个全注意力层生成的KV Cache和Token选择结果,还会继续提供给后续多个稀疏注意力层复用。两级共享叠加后,Cross-Decoder所需的KV Cache都可以根据Self-Decoder的隐藏状态构建。
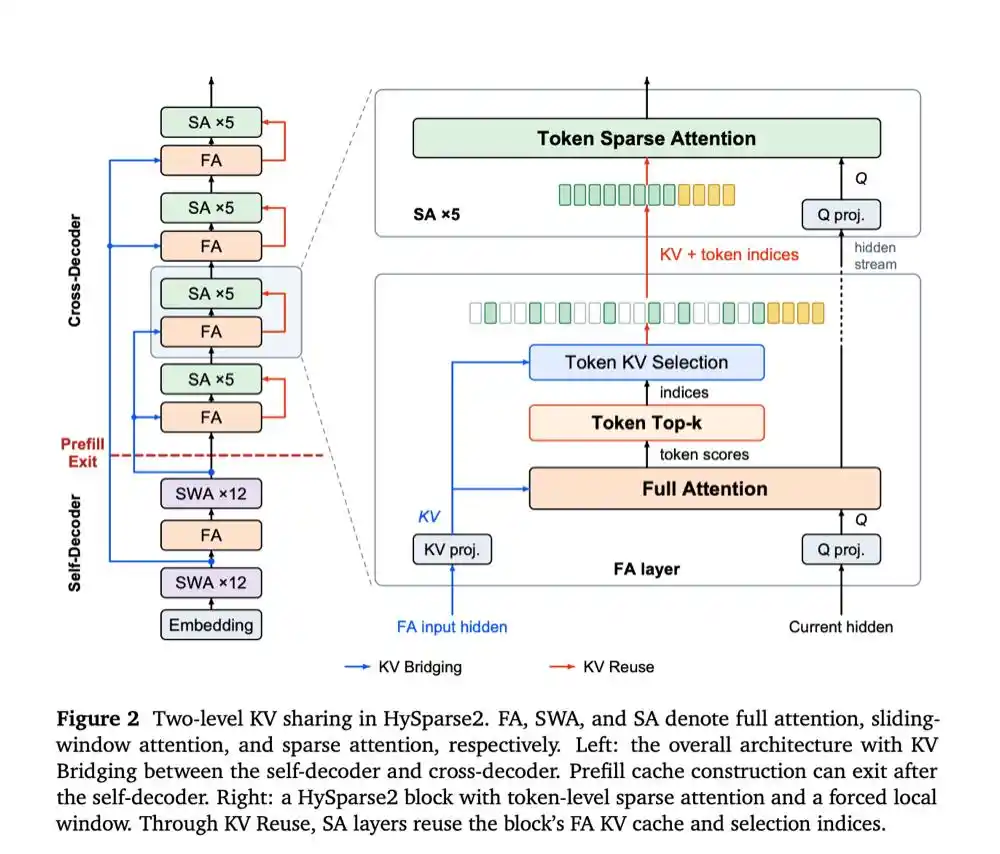
▲HySparse2的两级KV共享架构
Prefill执行完Self-Decoder即可退出,无需再让后半部分完整跑过一次长输入。
HySparse2还调整了寻找长上下文信息的方式。
上一代HySparse采用Block级选择,即一次选取一整块连续Token。HySparse2则改成了Token级选择,可以直接从上下文不同位置寻找相关Token。
这种变化更适合多轮Agent任务。比如一条真正有用的信息可能藏在很早之前的一次工具返回中,Block级方案为了取出其中一个Token,还需要一并处理周围的一整块内容;Token级方案则可以直接选择需要的位置。
论文消融实验显示,在相同注意力预算下,Token级方案在RULER-v2、MRCR-v2和GraphWalks等长上下文检索与图推理测试上均取得了更高得分。
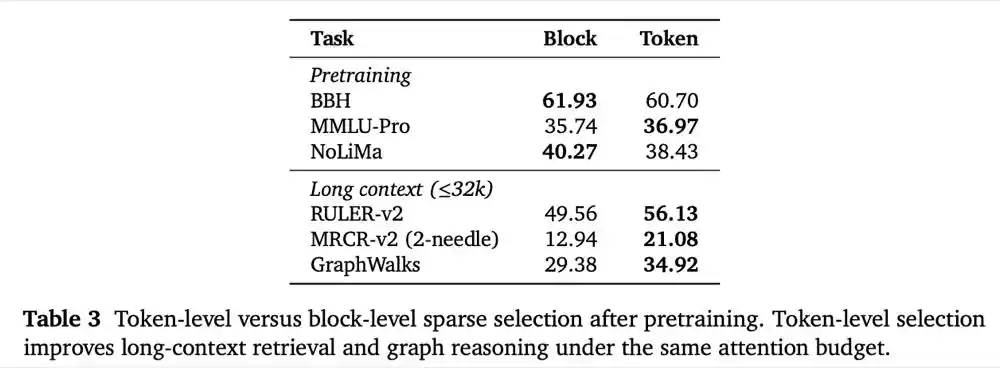
▲Token级与Block级稀疏选择效果对比
HySparse2同时取消了Cross-Decoder中单独的SWA分支,改为强制保留最近一段上下文。
论文实验中,每次固定保留最近128个Token,再从更早的上下文中选择1024个Token。近期信息和远距离信息因此能够共用同一份KV Cache,也减少了额外缓存。
以论文展示的49层模型为例,在Prefill与Decode分离部署时,Prefill节点只需要部署前25层,所需模型权重接近减半;这一阶段只需要执行一个全注意力层。
03.
长上下文和Agent任务
效果提升更明显
为了验证HySparse2,小米团队训练了一组80B-A3B MoE模型,并与上一代HySparse以及MiMo-V2系列采用的Hybrid SWA进行比较。
三组模型采用相同的数据和训练计划,仅注意力架构不同。模型首先使用约5000亿Token进行预训练,上下文长度为32K;随后又使用约1000亿Token进行轻量后训练,并将上下文长度扩展至256K。
测试结果显示,HySparse2较明显的提升集中在长上下文检索和Agent任务。
经过后训练后,相比HySparse,HySparse2在MRCR-v2和RULER-v2上的平均得分分别提高11.30和19.81个百分点;相比Hybrid SWA,则分别提高6.44和18.65个百分点。
在256K上下文下,HySparse2的RULER-v2得分达到58.45,HySparse为32.61,Hybrid SWA为35.74。
与此同时,HySparse2在论文测试的各个上下文长度下,AgentPPL和LongPPL均低于另外两种架构。
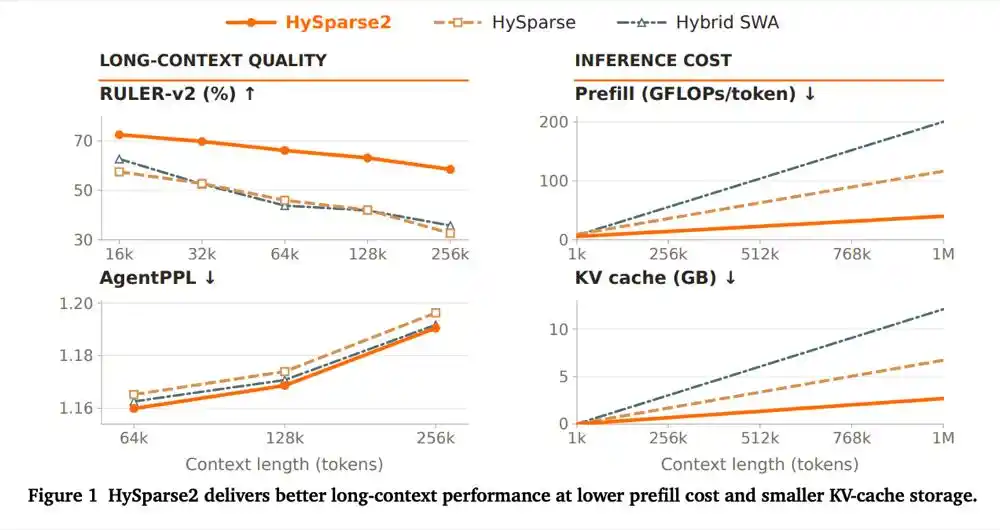
▲HySparse2在长上下文及Agent任务上的表现
计算和缓存方面的差距更加直接。
在100万Token上下文下,HySparse2的Prefill FLOPs相比HySparse降至约34%,相比MiMo-V2系列采用的Hybrid SWA降至约20%。
同一条件下,HySparse2的KV Cache占用为2.69GB,HySparse为6.72GB,Hybrid SWA达到12.09GB。换算下来,相比Hybrid SWA,HySparse2的缓存占用降至约1/4.5。
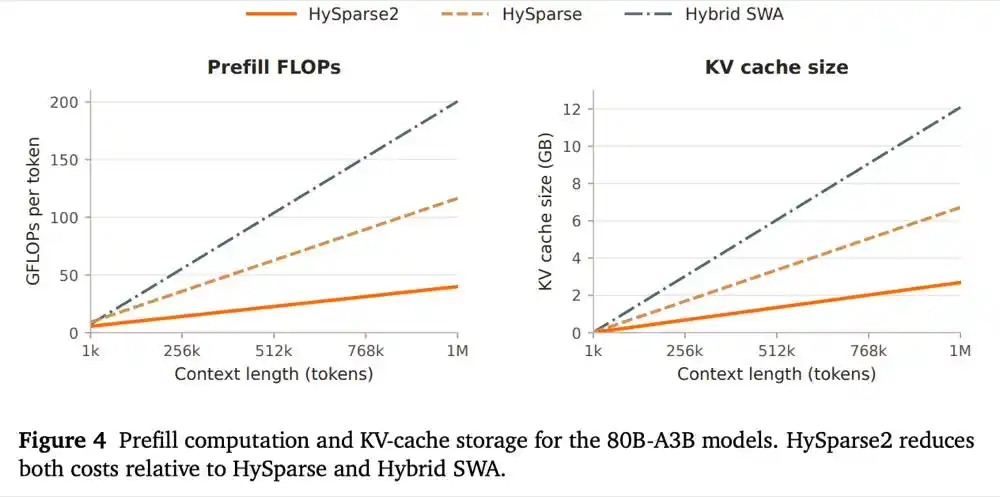
▲不同架构在长上下文下的Prefill计算量和KV Cache占用对比
在通用能力部分,小米团队给出的结论相对克制:三种架构在知识、推理和代码等能力上的整体表现大致相当,不同测试项目各有高低。
例如,HySparse2在BBH和MMLU-Pro上的成绩更高,HySparse则在DROP等项目上表现更好。
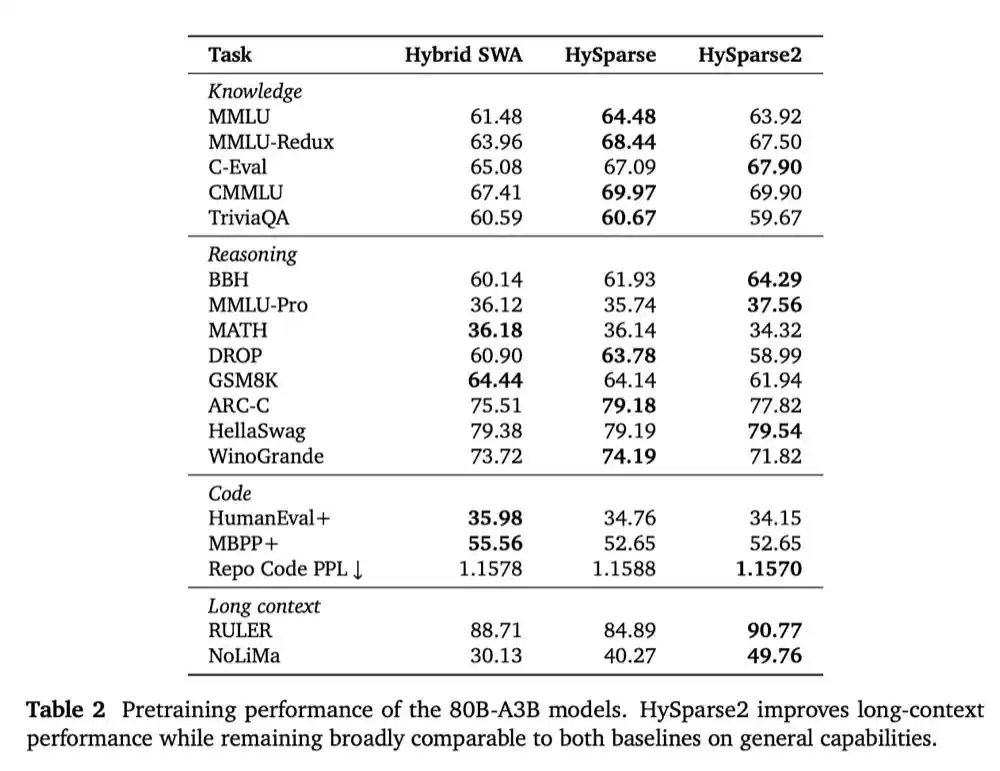
▲HySparse2与HySparse、Hybrid SWA在知识、推理、代码及长上下文任务上的表现对比
相比这些常规测试,HySparse2在RULER、NoLiMa等长上下文任务上的提升更加突出。
论文还通过消融实验验证了不同设计带来的影响。
例如,取消独立SWA分支、采用强制局部窗口后,部分数学推理和MRCR-v2成绩有所变化,但这一设计省去了额外投影参数和局部KV Cache,同时让Prefill可以在模型中途直接退出。小米团队将其视为效率和模型能力之间的一项架构取舍。
04.
结语:MiMo-V3箭在弦上
罗福莉抢先亮剑
MiMo-V2.6刚刚发布两天,罗福莉已经提前透露了MiMo-V3的一项关键架构变化。
按照论文中的设计,HySparse2通过两级KV共享,让Prefill阶段只需运行大约一半模型,同时进一步减少长上下文计算量和KV Cache占用,并在多项长上下文、Agent任务上取得更高得分。
这也让MiMo-V3的一个技术方向提前变得清晰:面对越来越长、越来越多轮的Agent任务,小米正在继续压缩模型处理长输入的计算与存储成本。
从MiMo-V2.6押注大规模RL,到MiMo-V3提前亮出新的底层架构,小米MiMo团队的模型迭代节奏还在继续加快。
接下来,HySparse2会如何落到完整的MiMo-V3上,以及这套架构最终能带来怎样的实际表现,也值得继续关注。
本文来自微信公众号“智东西”(ID:zhidxcom),作者:江宇,编辑:李水青
本内容旨在传递行业动态,不构成投资建议或承诺。


24H热门新闻
暂无内容
