







从TOPS到真实负载,AI芯片的评判标准正在改变
半导体产业纵横热度: 5137
AI智能体(Agent)落地推动AI芯片评价标准从纸面峰值算力(如TOPS)转向真实业务场景下的端到端效率、长周期运行稳定性及软硬件协同能力;存储墙、内存可靠性、异构协同成为关键瓶颈,存算一体、Chiplet/3D堆叠、RISC-V等多元硬件路线并行发展,但均高度依赖全栈软件生态支撑。
 摘要由 Mars AI 生成
本摘要由 Mars AI 模型生成,其生成内容的准确性、完整性还处于迭代更新阶段。
当Agent从演示原型走向生产级落地,产业正在直面一组尖锐的现实矛盾:上层模型、智能体算法迭代周期压缩至半年,而一颗AI芯片从需求定义、架构设计到流片量产,往往要耗费数年。过去行业习惯于追逐单芯片纸面峰值算力,但来自一线业务的反馈不断提醒行业,智能体长周期运行、多轮交互、频繁工具调用的特性,会持续暴露出存储、调度、异构协同当中的各类隐性瓶颈。算力的评判标尺正在发生潜移默化的转移,端到端执行效率、系统长时间运行的稳定性,逐步成为商业化落地的硬性约束。
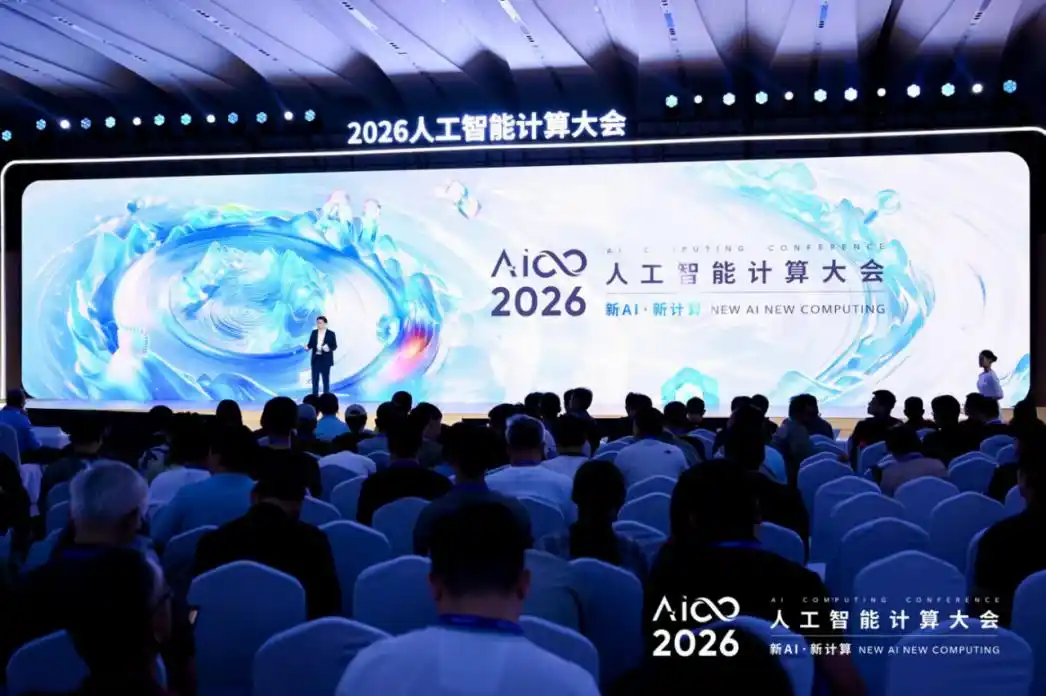
智能体正在重塑AI负载特征,产业思考也随之转向。9月21日,AICC2026人工智能计算大会在北京中关村国际创新中心落幕。置身会场中能切身感受到:行业正在重新求索,何种硬件与系统架构,能够承接智能体带来的新业务需求。
负载范式彻底迁移,Agent改写硬件的评价逻辑
Agent带来的变革,并非简单的算力需求暴涨,而是一整套负载范式的根本性迁移。
IDC副总裁周震刚在大会现场带来《2026中国人工智能计算力发展评估报告》,他把算力需求的爆发拆解成三重乘数:任务执行频次、单任务Token消耗、多智能体协同效应,多重因素叠加,共同推高全社会算力消耗。区别于传统大模型单次问答式推理,生产环境下的智能体属于长周期任务形态,会涉及海量知识库读取、多轮推理生成、外部工具调用、会话状态留存、出错回滚重试,同时需要支撑大规模实例并发运行。
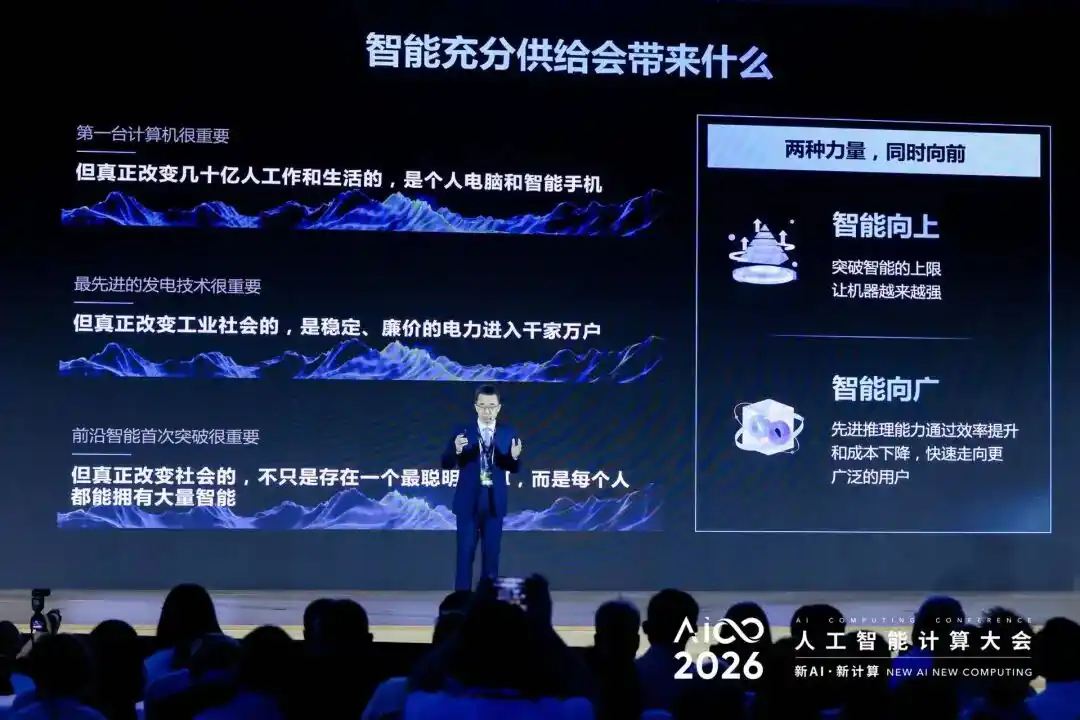
负载形态的改变,也直接重塑硬件以及系统协同层面的分工关系。浪潮信息首席AI战略官刘军在交流中谈到,进入Agent阶段后,AI不再只是完成一次模型调用,而是需要持续进行任务规划、工具调用、状态管理、结果校验和多轮迭代。计算负载因此变得更长、更复杂,也更加动态,对CPU、加速器、内存、存储、互联以及系统软件的协同提出了新的要求。在他的判断里,智能不再只是人类独有的稀缺能力,AI计算呈现两个重要的发展方向:一层向上,不断逼向智能上限;一层向广,实现充分供给。这一产业层面的变化,会自上而下传导到系统架构设计的方方面面。
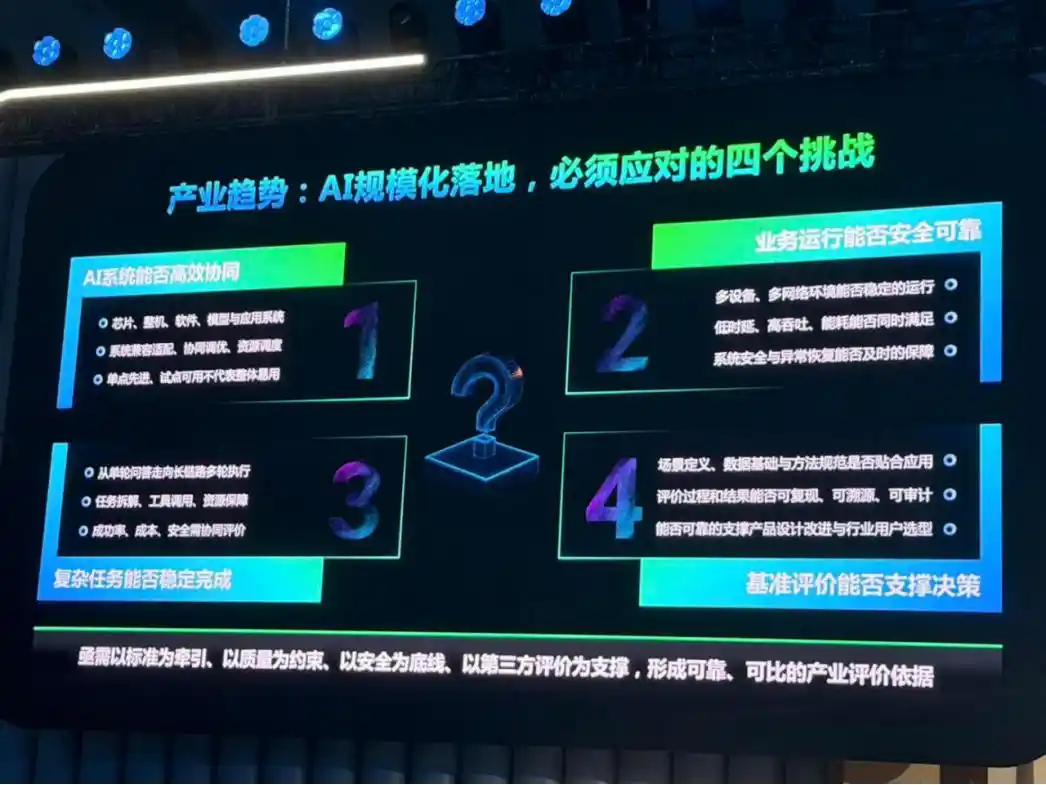
不少企业的落地实践,也抛出值得警惕的现实问题。工信部电子五所软件与系统研究院高级副院长蒋沛航就观察到,很多芯片在标准化单点基准测试中跑分优异,但投入Agent真实生产环境,面对多步骤、高并发的复杂任务,极易出现任务中断、输出跑偏的现象。硬件纸面性能指标,并不等同于真实业务场景下的可用能力。全链路的稳定性,已经成为Agent规模化落地不可回避的硬性门槛,这一点,也在多家企业一线落地实践中得到反复印证。
智能体场景下,长上下文带来巨大压力,KV Cache规模持续膨胀,会衍生内存溢出、首字时延恶化、Token间隔抖动等一系列连锁问题。任务不再是固定的计算流程,充斥大量不可预判的分支与重试逻辑,内存容量、带宽、片间互联、资源隔离、全局任务调度,都有可能转变为系统瓶颈。这也引申出行业需要回答的核心命题:面对动态多变的新型负载,硬件可以解决哪些问题,又有哪些诉求必须交由系统与软件完成。
直面存储墙,多元技术路线并行,各有能力边界
存储与访存效率是大会上被频繁讨论的话题之一。
过去十年AI算力实现数百倍增长,但内存带宽提升远远跟不上算力扩张的脚步。Agent业务需要持续生成、更新、保存大量KV Cache与任务状态,进一步放大访存压力。这意味着,存储系统与计算系统之间的协同变得更加重要。对于国内市场而言,在芯片架构、存储技术和供应链条件日益多元的背景下,行业也在多条技术方向上并行探索破局路径。
对于存算一体这条被寄予厚望的技术路线,清华大学副校长吴华强结合团队多年的研发实践给出清醒判断:不能把希望完全寄托在器件单点突破,器件、工艺、电路、架构,一直到编译器、推理框架,完整的全栈协同缺一不可。依靠非易失存储器件搭建交叉阵列,把计算贴近存储单元,存算一体在RAG检索、向量数据库这类访存占比较高的场景,能够释放突出的能效收益。但模拟计算本身自带器件波动、阵列映射等现实难题,也划定了它的能力边界:它更适配特定访存密集场景,面对大量分支跳转、复杂通用计算的完整智能体业务链路,很难做到全场景通吃。
单颗芯片受面积、功耗、工艺的物理上限约束,Chiplet与3D混合堆叠成为另一条重要解题思路。北极雄芯创始人&首席科学家马恺声结合自身产品研发经历预判,未来一到两年,行业将迎来大参数量模型、高Token吞吐、上千容器协同、上千小时不间断运行的Agent系统,单颗芯片很难覆盖全部业务诉求。Chiplet、3D堆叠的价值,并不只是依靠裸片拼接去拉高总算力,更核心的意义来自拆分组合带来的架构弹性,以此缓解模型迭代快、硬件研发周期漫长之间的现实矛盾。
不过先进封装并不是万能解法。算苗科技首席AI科学家楼建光在分享中坦言,3D堆叠能够把互连距离压缩至微米级别,大幅提升带宽、降低数据搬运功耗,但良率管控、散热设计、配套软件生态,都是落地路上绕不开的现实阻碍,不能简单把现有GPU/NPU架构直接照搬复用,需要面向Transformer做以内存为中心的原生架构设计。
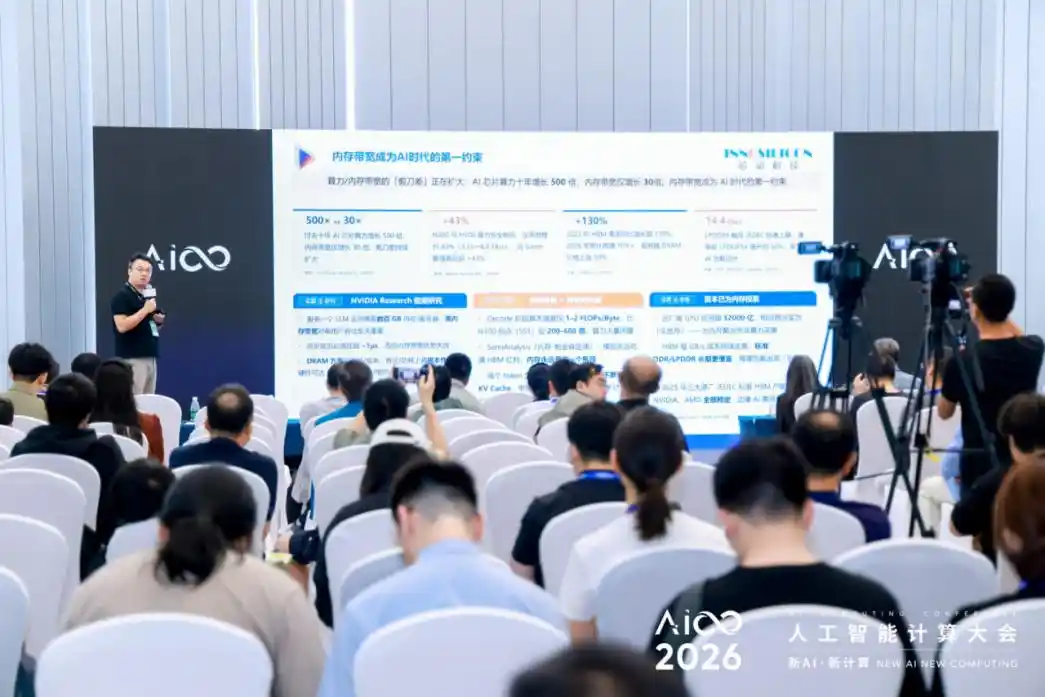
即便用上3D堆叠、Chiplet这类先进架构,内存层面的瓶颈依旧无法被彻底消除。芯动科技DDR产品线总监张杰表示,从IP产业一线落地视角拆解其中的现实风险:Agent任务往往会持续十几分钟甚至更久,一旦内存出现关键数据错误,就会造成整段已经完成的任务全部作废,带来实打实的业务损失。也正是这个原因,面向Agent业务,内存运行稳定性的地位,已经提升到和性能同等重要。LPDDR6新增Meta空间等保护机制,同时在未来会内置PIM存内计算能力,可以在存储颗粒内部完成一部分简单计算,减轻主芯片压力,但它只能缓解部分数据搬运压力,不可能彻底根除存储墙。HBM、3D-DRAM、新一代DDR各有自己的适配区间,带宽、容量、可靠性、成本之间,永远需要做现实层面的权衡取舍。
因此,硬件可以攻克器件极限、算力规模、物理层面的数据搬运等瓶颈。但Agent任务之中的动态任务调度、实例状态维护、故障重试恢复、异构多芯片协同,已经超出纯硬件的解决范畴,最终需要系统软件栈承接实现。硬件架构再先进,如果上层软件适配跟不上,再亮眼的硬件参数,也很难转化为真实可用的业务能力。
RISC-V的新考题,硬件能力,终究要靠完整软件生态兑现
Agent混合负载的兴起,正在拓展RISC-V的应用边界,使其从传统MCU、低功耗嵌入式场景,进一步走向服务器和AI计算领域。不管是论坛分享还是企业专访,很多从业者都提到同一个现实:打磨好硬件IP仅仅只是起点,稳定性、兼容性、整套基础软件底座的成熟度,往往才是规模化落地最大的拦路虎。
进迭时空科技有限公司产品负责人朱伟东,结合在RISC‑V芯片研发过程中积累的一线体会表示,过去行业对RISC-V的印象大多停留在端侧、MCU领域,但Agent时代长上下文、大规模KV Cache、7×24小时不间断运行的业务诉求,把服务器级别的可靠性要求摆到台前。一颗服务器芯片成败,不单单看CPU核本身的跑分,RDMA网络、虚拟化、操作系统适配、AI推理框架整套底座是否完备至关重要。不少场景之下,软件生态建设投入的工作量,甚至超过硬件IP研发本身。
在他看来,长上下文带来的压力,不只是算力层面,更大的压力落在内存子系统。KV Cache规模膨胀,会引发内存溢出、首字时延恶化、Token之间间隔抖动等连锁问题。业界普遍采用软硬件协同的分层存储思路应对:高频访问的热缓存放在高速内存,冷的历史上下文下沉至低速存储介质,再配合Page Attention这类软件算法,压低硬件侧的压力。而在产品选型阶段,服务器场景下稳定性、RAS可靠性的优先级,甚至会排在原始性能指标之前。
面向AI混合负载,RISC-V需要引入AI向量、矩阵指令扩展,而扩展行为天然伴随着生态碎片化风险。与会嘉宾在报告中对IME、VME、AME三条AI指令扩展路线进行了梳理,不同方案在寄存器组织、计算单元设计上各有取舍。如果各家大量采用私有定制扩展,上层推理框架就要承担繁重的适配工作,抬高全产业成本,推动形成社区公认的公共指令标准,才是降低产业负担的可行路径。
指令集标准仅仅只是起点。北京大学讲席教授、北京开源芯片研究院首席科学家、北京通明湖信息技术应用创新中心主任、复旦大学先进计算系统研究院院长谢涛指出,RISC-V的开放,不能止步于指令集本身,我们应该把视角从硬件IP拉升至完整系统生态。
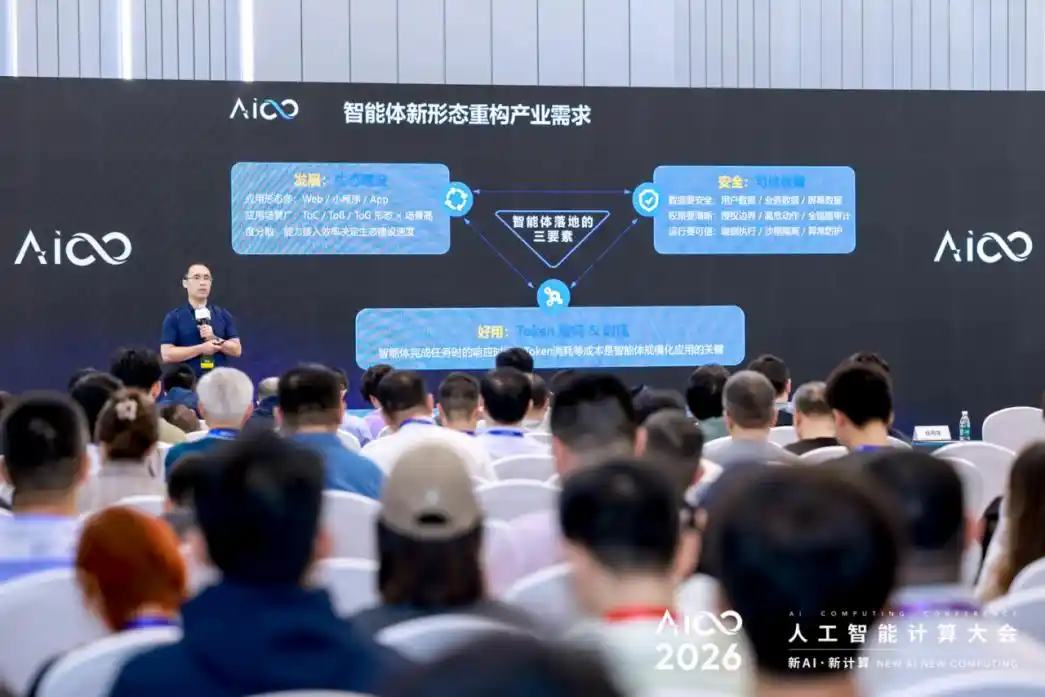
谢涛分析,AIGC时代算力重心高度偏向加速芯片,Agent场景大量编排、工具执行任务拉高CPU负载,CPU与加速单元走向更加均衡的配比。传统外挂异构架构中CPU负责调度、XPU完成AI计算,中间会产生大量数据拷贝开销;RISC-V通过矩阵、张量指令扩展,把AI计算能力变成CPU指令集原生能力,走向同构计算,可以削减数据搬移开销,简化编程模型。当然同构计算也不是万能方案,超大算力云侧场景中外挂加速器依旧具备不可替代性,两类路线各有适用边界。
他同时也客观指出推进统一RISC-V AI指令扩展标准的现实矛盾:不同业务场景对算力、功耗诉求差异巨大,厂商做私有扩展,硬件迭代更加灵活敏捷,但后续软件适配成本会指数级上升;严格遵循社区标准,又会对部分微架构创新形成约束,这是产业需要持续权衡的命题。Vibe-Coding一类AI辅助开发范式,可以辅助算子生成、编译器迁移,降低一部分适配工作量,但不能寄希望以此完全跳过基础软件生态的共建。海外商业企业整体偏观望,国内基于现实产业诉求,有组织地推动RISC-V+AI OS全栈建设,属于我们独有的时代机遇。
硬件IP、指令标准之外,软件栈主线化适配是绕不开的现实难题。朱伟东结合产品实践提到,当下不少RISC-V相关代码还停留在各厂商私有分支,没有合入Linux内核、PyTorch等上游主线,上游版本迭代之后,下游就要投入人力持续同步维护,维护成本居高不下,推动代码合入社区主线,是RISC-V服务器实现规模化商用的必经之路。智源研究院Flag OS开源软件栈的实践同样证明,无论硬件设计如何先进,都需要编译器、算子库、模型Day-0适配、自动化部署工具承接;国内数量众多的异构国产算力,亟需统一的南向适配框架,把分散的硬件能力,转化为上层业务可以调用的算力。
算力竞争,本质是全栈生态的较量
综合本次AICC大会得到信息可以得出结论:不存在单一芯片架构,能够完整承接Agent的全部业务链路。
存算一体在高访存场景具备能效优势,但并不擅长处理大量通用分支任务;3D-Chiplet带来宝贵的架构弹性,落地却受制于良率、散热与软件配套;RISC-V具备开放灵活的底座,但价值释放高度依赖公共指令标准、操作系统、推理框架共同组成的完整软件体系。同时,不管采用哪一种硬件路线,面向长时间运行的Agent业务,内存子系统的稳定性,是产业选型不可忽视的关键权重。
因此,Agent时代,评判芯片的标尺已经发生迁移,纸面峰值算力不再是唯一的衡量标准,真实业务下的端到端效率、长周期运行稳定性、软硬件协同能力权重持续抬升。模型迭代快、芯片研发周期漫长的矛盾,不能单纯依靠硬件工艺与架构硬追赶。模块化硬件设计,必须搭配开放完整的全栈软件系统,才能够获得足够的迭代弹性,跟上上层业务快速变化。
国内拥有多元化硬件路线、完整产业链,同时积累大量Agent落地场景,这是得天独厚的产业优势。如何依托系统层面的协同创新,把碎片化的异构硬件,整合成稳定、可负担、能够规模化供给的Agent算力底座,将成为未来持续发展的关键议题。
在智能体掀起的这场变革中,芯片架构创新仅仅是上半场。AICC2026现场释放出一个清晰信号:市场竞争的核心正在转向覆盖器件、芯片、存储互联、操作系统与AI推理框架的全栈生态比拼,这正是算力能否落地的关键。
本文来自微信公众号 “半导体产业纵横”(ID:ICViews),作者:子皓
本内容旨在传递行业动态,不构成投资建议或承诺。


24H热门新闻
暂无内容
