






10秒生成4K图:MiniMax再次拿出开源SOTA
机器之心热度: 4002
MiniMax发布开源图像生成模型H3 Image,支持原生4K直出、10秒级生成、最多16张参考图,在文生图和图像编辑两项开源榜单中位列第一;实测显示其在真实感、文字渲染、人像细节、物理结构理解及指令遵循能力上表现突出,基于全模态视频模型H3衍生,参数量达331亿,已引发全球开发者生态共建。
 摘要由 Mars AI 生成
本摘要由 Mars AI 模型生成,其生成内容的准确性、完整性还处于迭代更新阶段。
「GPT is cooked.」
这两天,这句话在 AI 社区里反复出现。让人坐不住的是
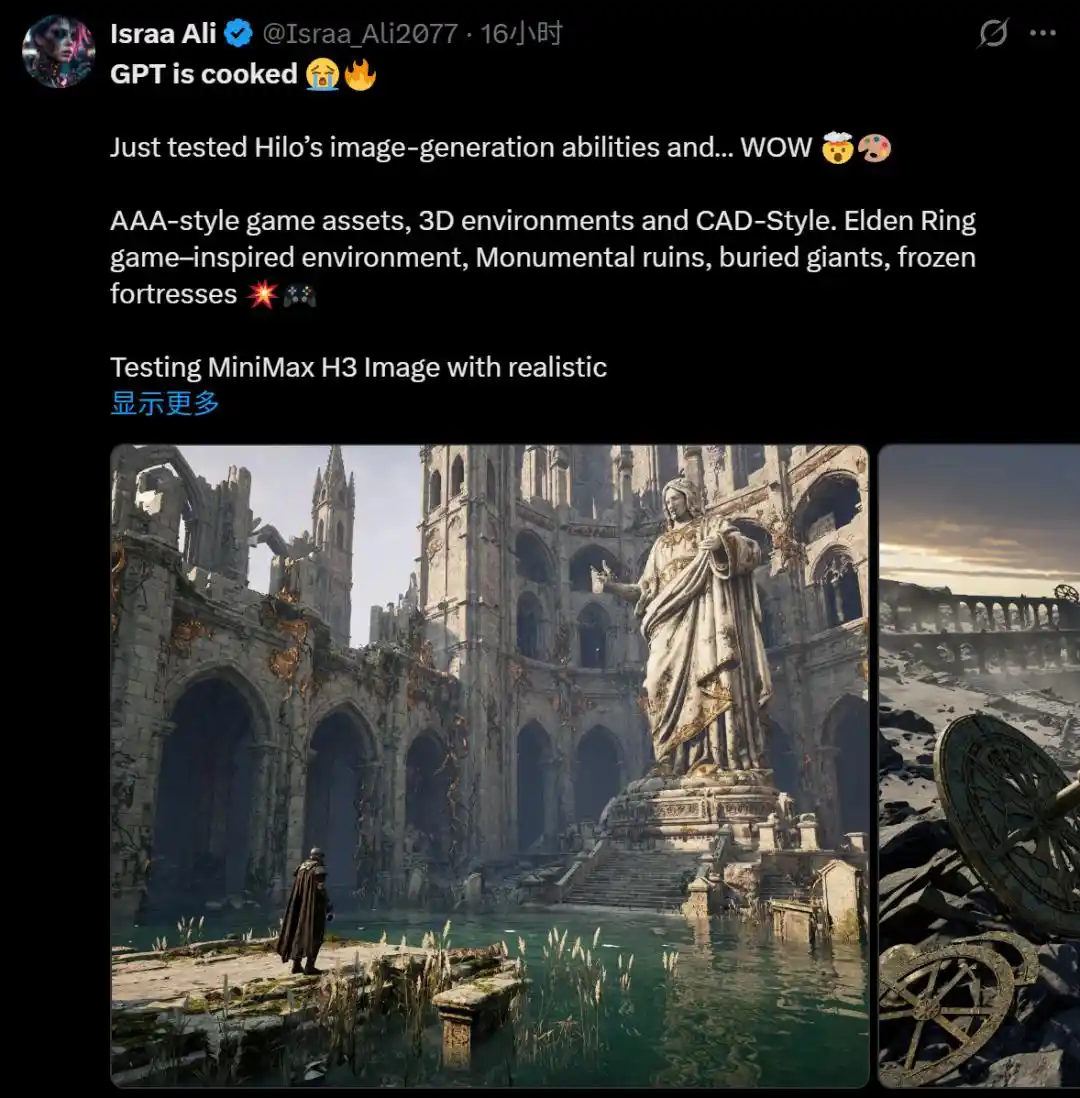
这是一个原生 4K 直出、10 秒级生成、支持 16 张参考图的模型,本周二刚刚开源,刷新了开源图像模型的 SOTA。从大家的第一波反应看,这个说法似乎并不夸张。
有提前拿到内测权限的开发者进行了大量测试。在新模型输出的内容里,AI 人像那层「塑料皮」没了,毛孔、雀斑、汗毛都清晰可见。人们对它在游戏设计、角色设定和 3D 场景上的能力赞不绝口。
在今天更新的 Artificial Analysis 榜单上,
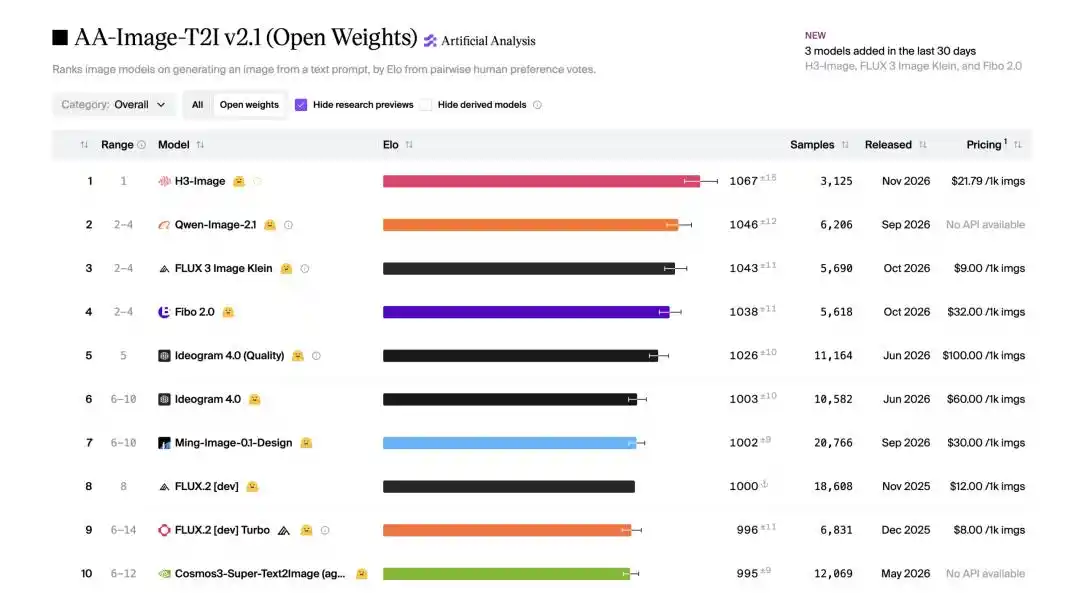
GitHub:https://github.com/
HuggingFace:https://huggingface.co/
我们第一时间拿到了新模型的使用权限,帮大家看看实测是个什么水平。
重新定义画面美学与「真实感」
这款新模型已经在
我们以普通用户的视角,把日常会用到的场景按四个能力维度挨个测了一遍,先看真实感,再啃文字和人脸这两个经典难题,最后试试图生图的二次创作。
真实效果是第一关。最容易暴露 AI 痕迹的,往往是我们每天都在看的东西,比如微信聊天界面。
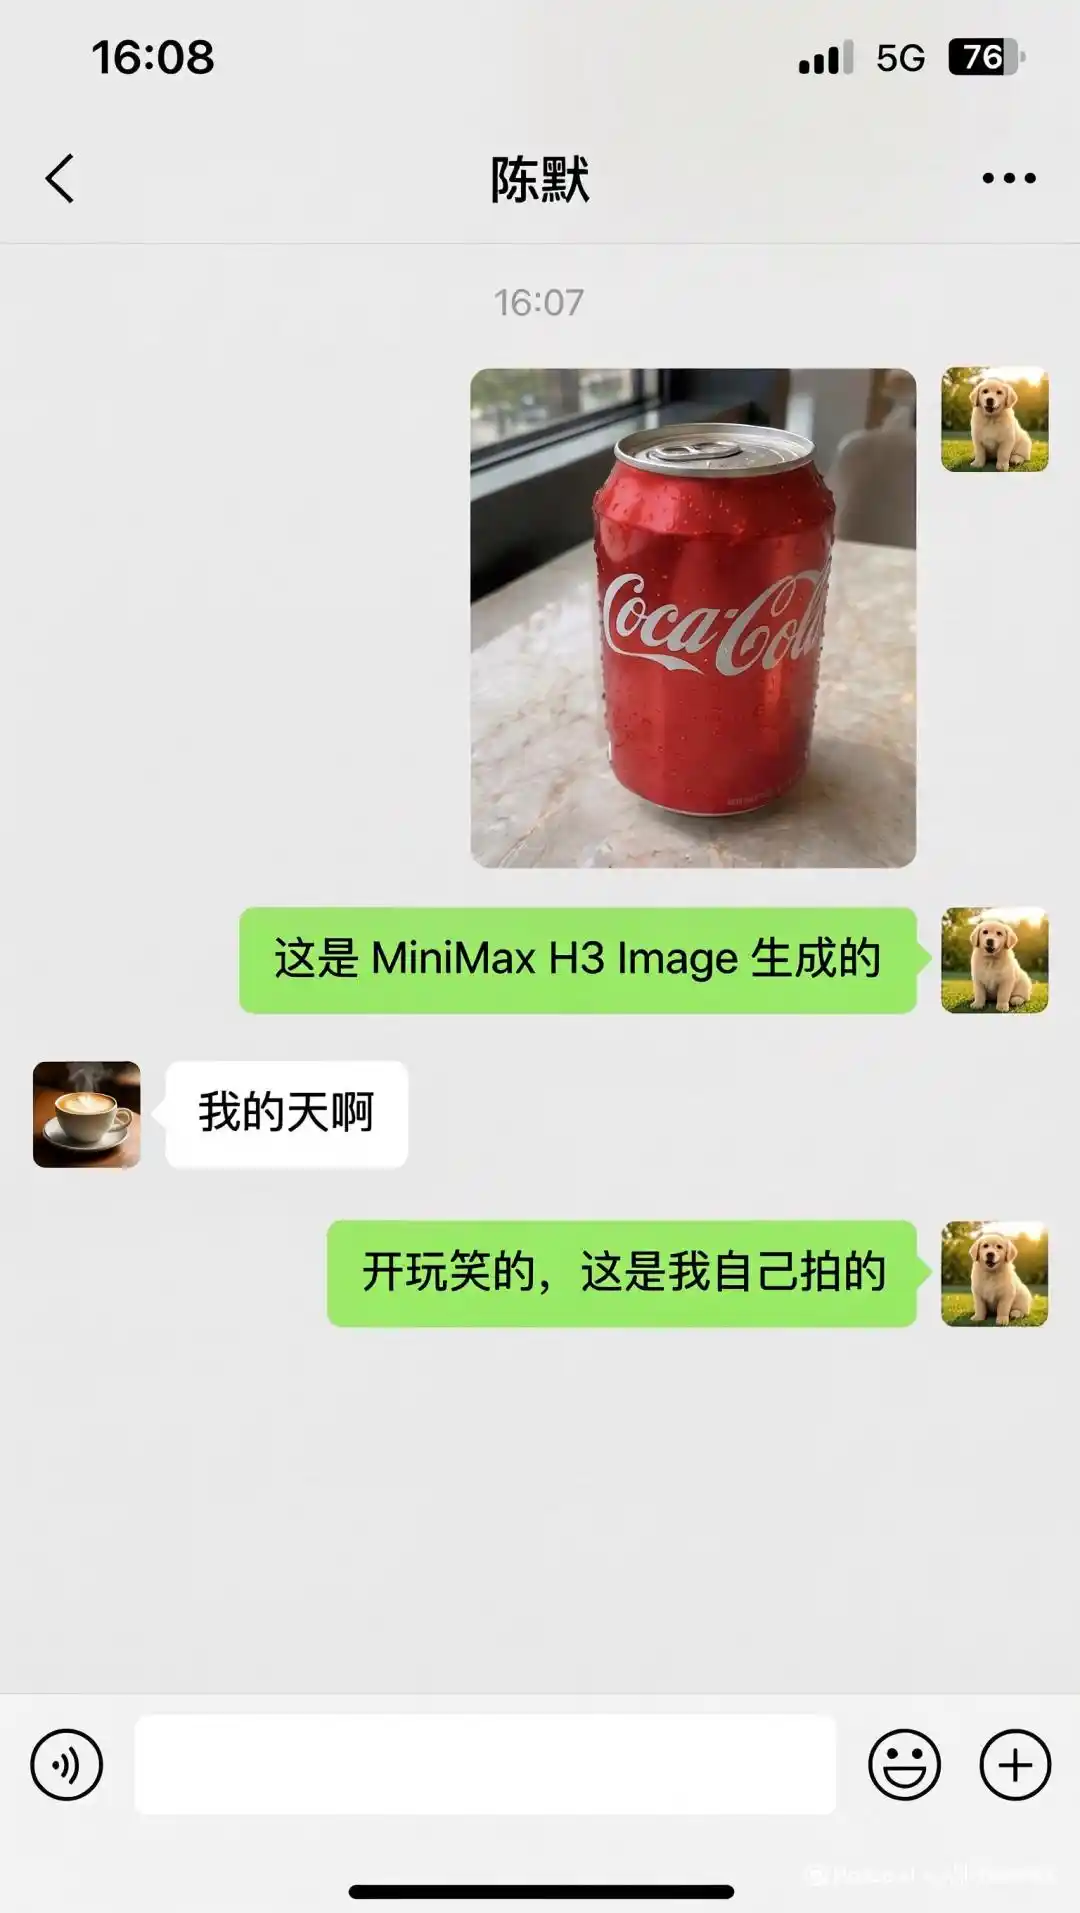
提示词:生成一张微信聊天截图:我先给对方发送一张非常逼真的可口可乐照片,并说:“这是
我们只输入一段提示词,
这类日常界面之所以难,是因为人眼对熟悉场景的容错率极低。微信界面有相对固定的视觉规范,字体稍微偏粗、聊天气泡间距差一点,或者状态栏图标比例不对,立刻就会被识破。
很多模型在生成类似聊天截图时,要么界面元素错位变形,要么产品照片出现不自然的高光,真实感大打折扣。
而
接下来是生图模型的老大难问题,即文字的渲染。以往的模型不是错字、乱码,就是拼写崩坏,这次我们直接让 H3 Image 来个复杂的,生成张涂鸦:
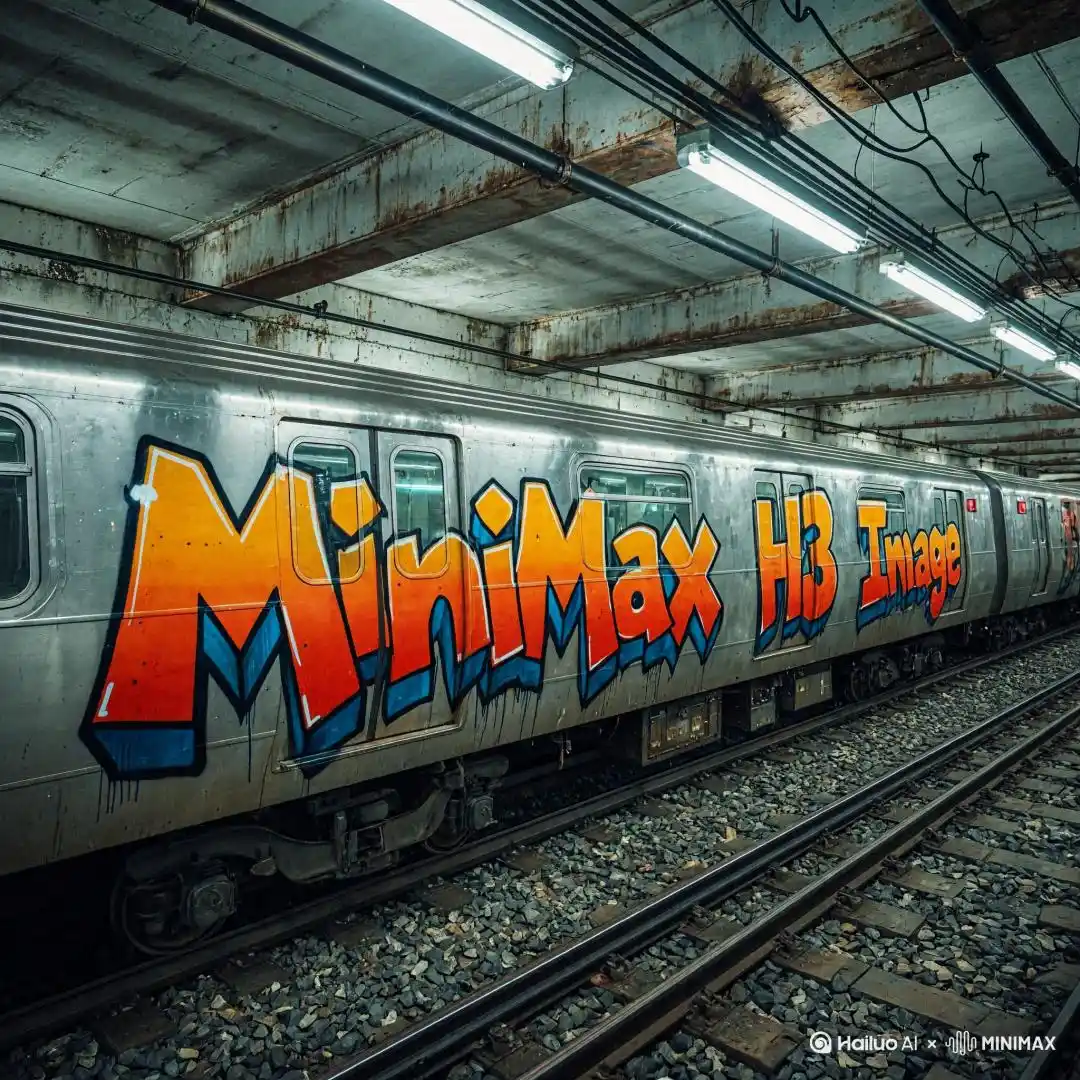
提示词:这是一张写实风格的竖构图照片,画面中一列带有岁月痕迹的银色不锈钢地铁车厢停靠在粗粝的地下车站内。车厢侧面覆盖着一幅巨大的狂野风格涂鸦,横跨了整排车窗。涂鸦由棱角分明的 3D 立体块状字母组成,拼写出 “
「
人物写真想出大片感,考验的可不只是颜值,面部刻画、服装细节和光影氛围都得在线。我们挑战了一组维密后台大片:
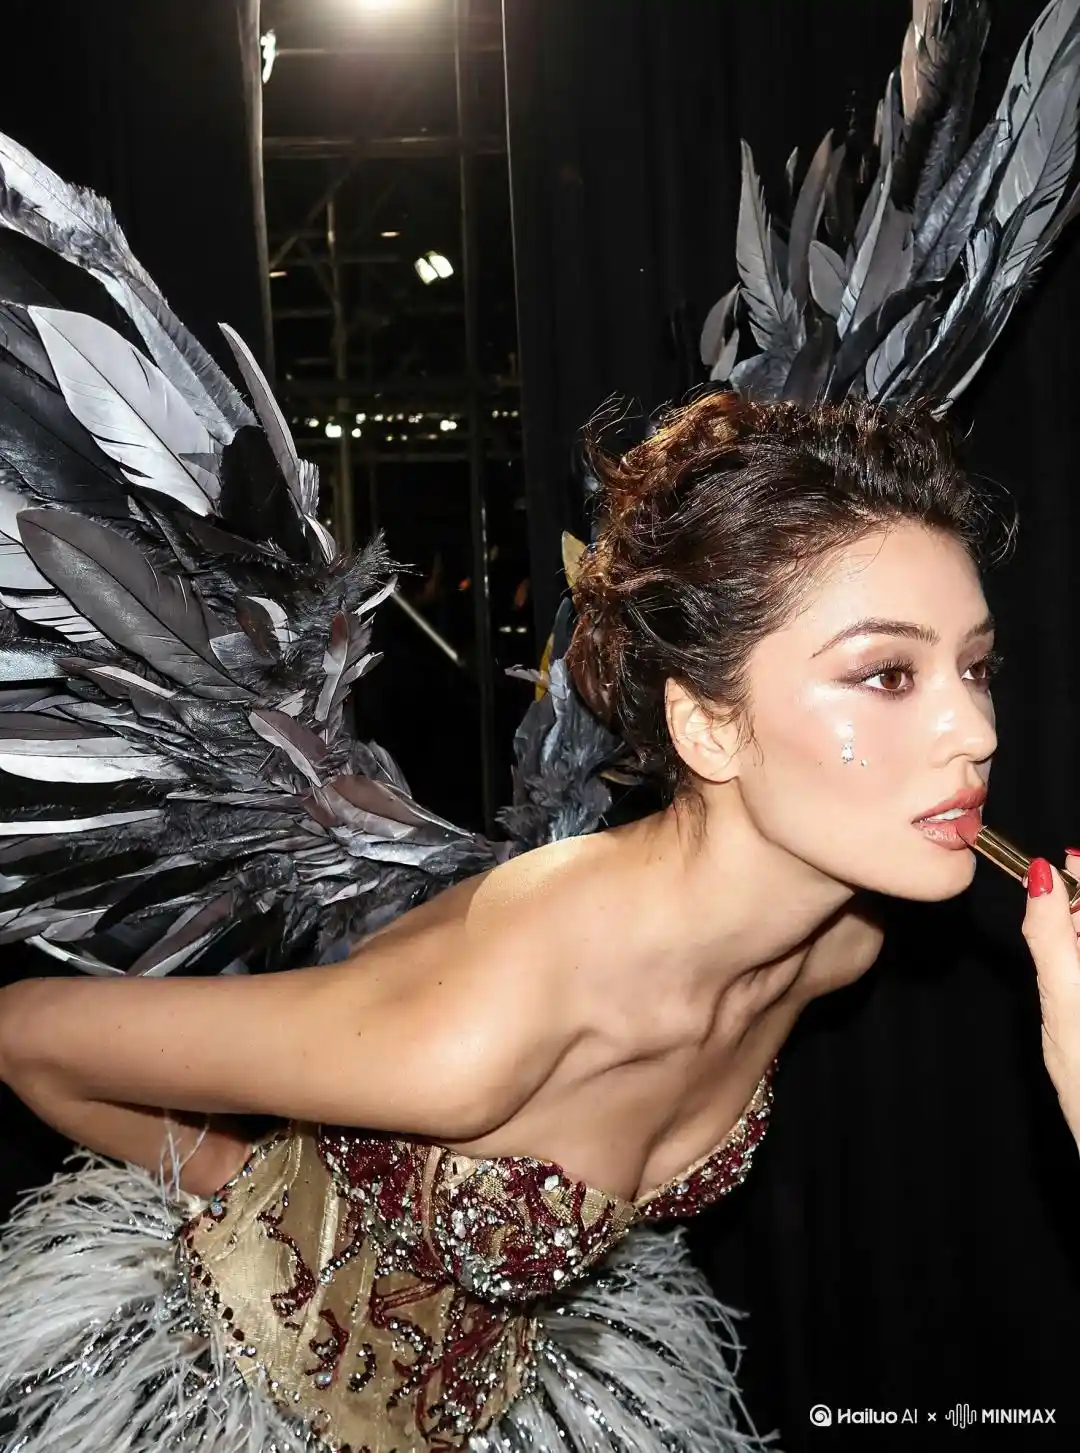
提示词:Create a glamorous photoshoot in the style of Victoria’s Secret. A young woman attached in the uploaded reference image ( Keep the face of the person 100% accurate from the reference image ) stands almost sideways, slightly bent forward, during the final preparation for the show. Makeup artists apply lipstick to her (only her hands are visible in the frame). She is wearing a corset decorated with beaded embroidery and crystals with a short fluffy skirt, as well as large feather wings. The image has a “backstage” effect.The background is a darkly lit room, probably under the podium. The main emphasis is on the girl’s face and the details of her costume. Emphasize the expressiveness of the gaze and the luxurious look of the outfit. The photo is lit by a flash from the camera, which emphasizes the shine of the beads and crystals on the corset, as well as the girl’s shiny skin. Victoria’s Secret style: sensuality, luxury, glamour. Very detailed. Important: do not change the face.
水晶珠饰、羽毛翅膀等复杂元素细节拉满,直闪打下来,模特皮肤光泽和服装反光层次分明,随手一拍就是时尚杂志内页。
换个风格,试试电影感人像:
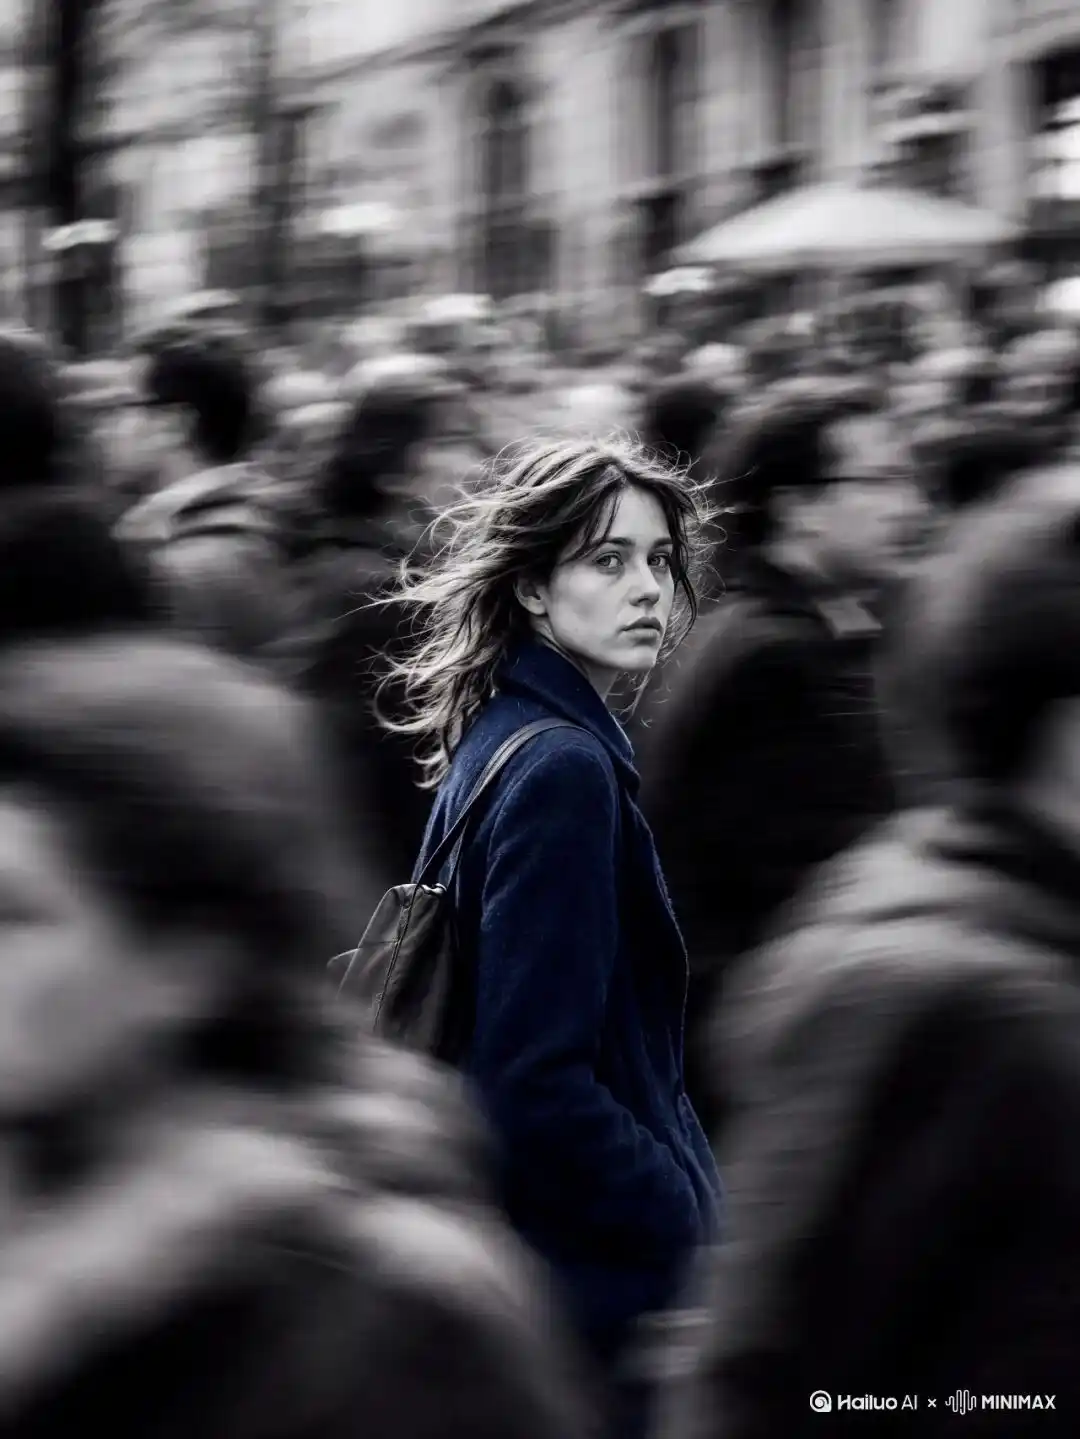
这张街头人像很有电影截图的感觉,人物回眸的瞬间被清晰定格,周围行人则被处理成大幅动态拖影,一静一动,画面张力一下就出来了,整体氛围、镜头感和情绪表达,都是在线的。
我们还解锁了千禧年复古写真。
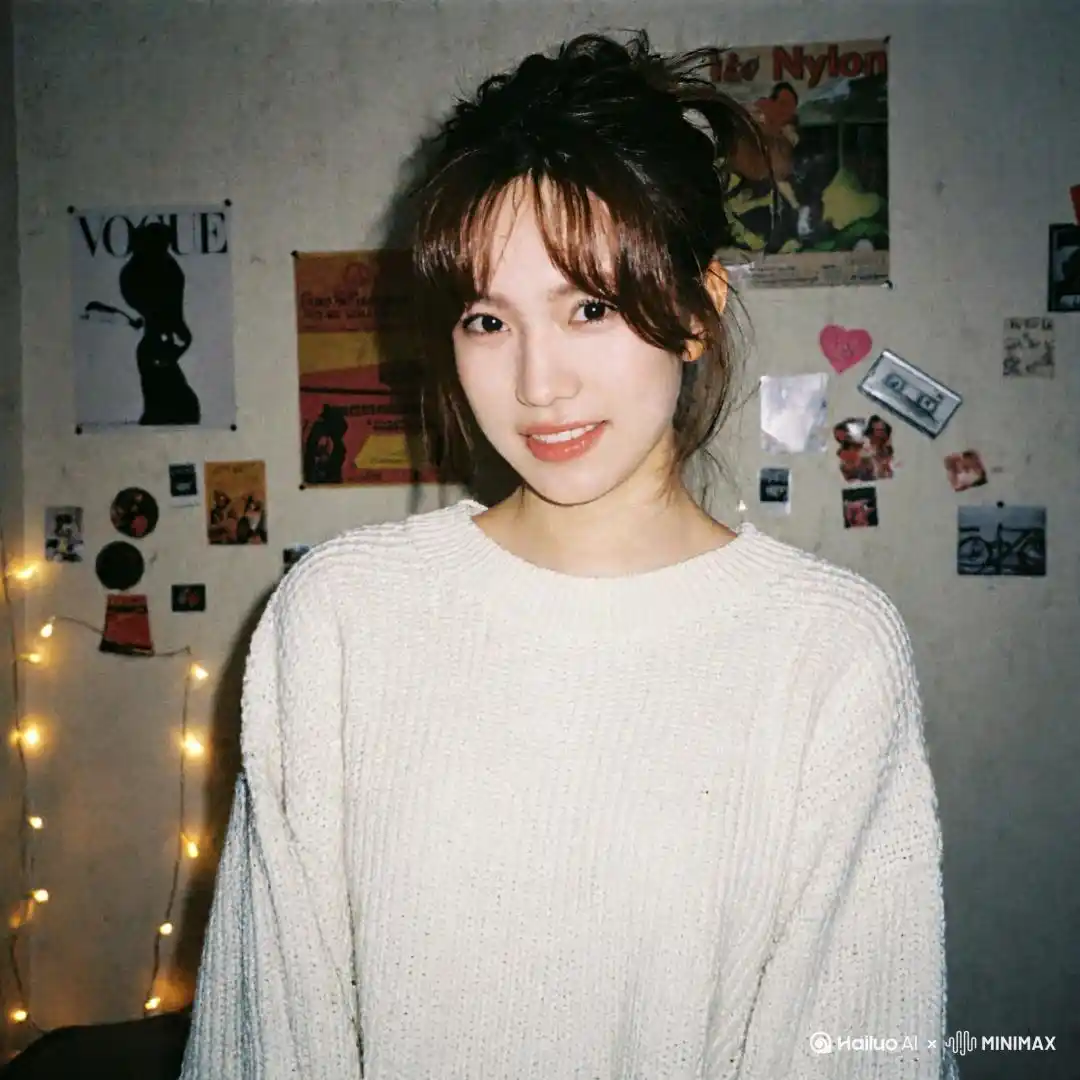
提示词:Without changing her original face, create a portrait of a beautiful young woman with porcelain-white skin, captured with a 1990s-style camera using a direct front flash. Her messy dark brown hair is tied up, posing with a calm yet playful smile. She wears a modern oversized cream sweater. The background is a dark white wall covered with aesthetic magazine posters and stickers, evoking a cozy bedroom or personal room atmosphere under dim lighting. The 35mm lens flash creates a nostalgic glow.
略带噪点的胶片质感、墙上的旧杂志海报、暖黄色串灯,一下把人拉回 2000 年代,轻微过曝也很有老式数码相机的 feel。提示词里那些琐碎的氛围细节,也都得到了还原。
文生图看完,再玩下图生图。这一部分要求AI 模型得看懂原图,再按指令改造。
先拿马斯克整个活儿。上传一张照片,让模型把他变成丑萌手绘微信表情包,人物原本的神态被夸张放大,配上歪歪扭扭的「So Dumb」、汗滴和问号,一张可以直接拿去斗图的表情包就做好了。
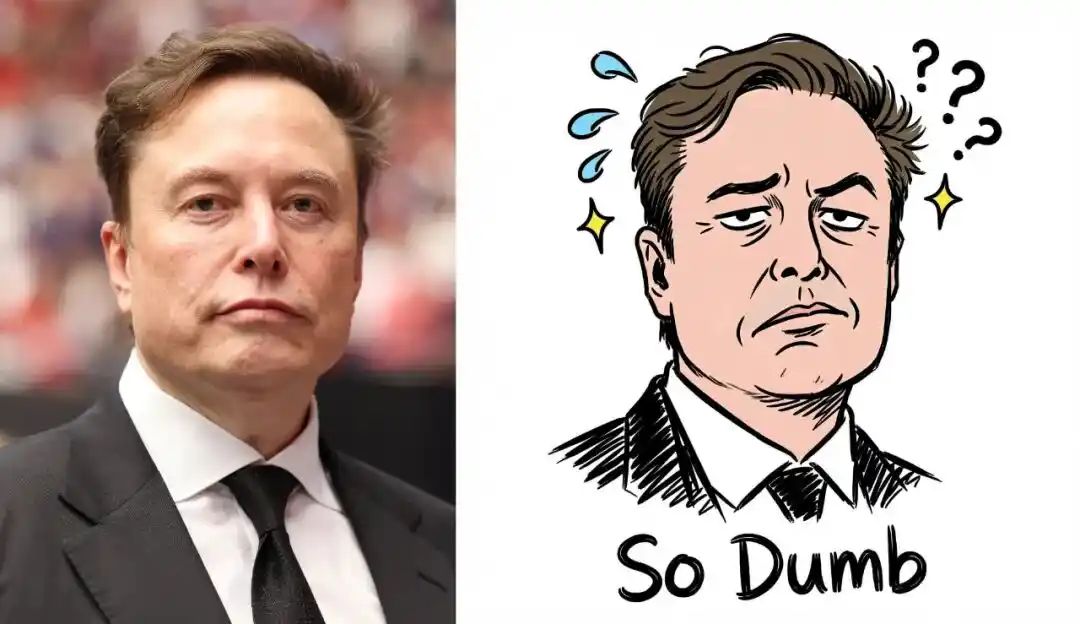
提示词:将其画成一张搞笑的手绘微信表情包。采用极简的丑萌线稿,带一点随手涂鸦的感觉,背景纯白。根据人物在原照片里的神态,夸张地画出它震惊、嫌弃或懒洋洋的样子。在头部周围加上几滴汗珠、问号或闪光小星星等可爱涂鸦。底部加上手写英文「So Dumb」,字迹歪歪扭扭,显得随意又好笑。
下一轮加大难度。上传一张街头 CCTV 监控照片,要求模型识别画面中的人物,逐一添加白色人脸框,并为最显眼的人物生成高清放大特写。
生成结果保留了原图的场景布局和监控视角,主画面维持了应有的噪点和轻微失真,放大框里的面部则更清晰,整体很像监控系统自动生成的分析画面。
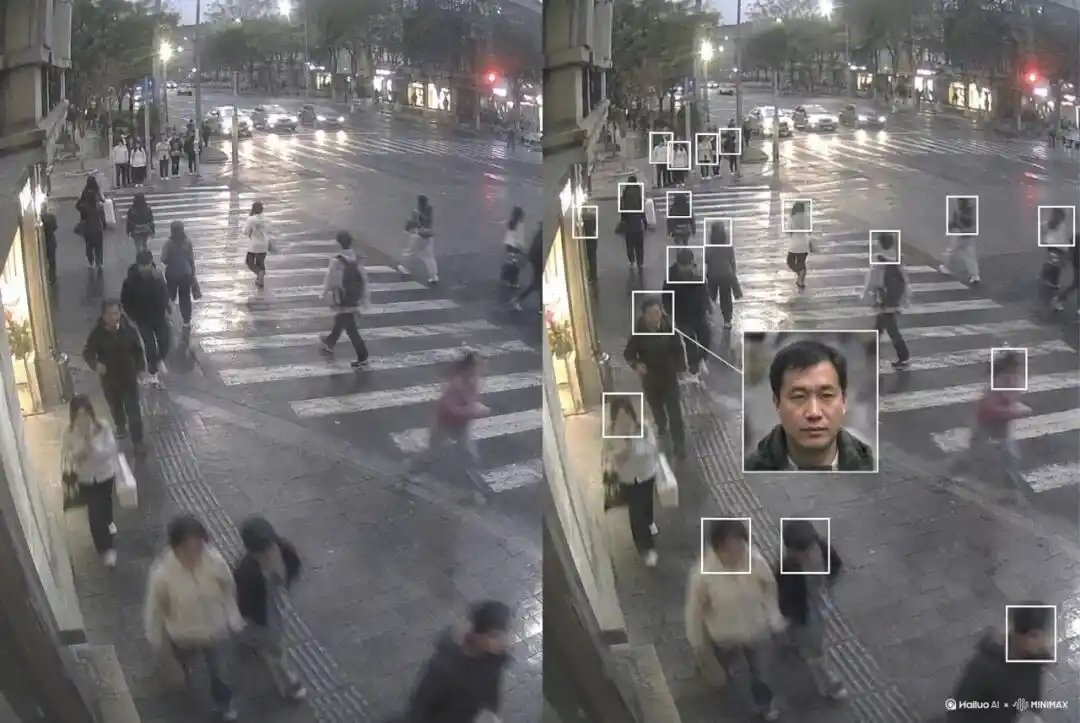
提示词:Create a high angle CCTV surveillance shot using the uploaded image as the source. Detect every visible person in the image and automatically draw a white rectangular bounding box around each face. For the most prominent person, add a large zoom in inset: a sharp, enhanced close-up of their face displayed in a floating rectangular frame connected with a thin white line.Keep the main image slightly noisy and security camera like (soft grain, slight distortion, muted colors), while the zoom in face box should be clearer, brighter, and more detailed. No text, no timestamps, no overlays except the boxes and connecting line. Maintain the original scene layout, angle, and environment of the uploaded image.
如果想要进行画风转换,这样一张真实风格的图,我们让它转换成二次元的拼贴风格:
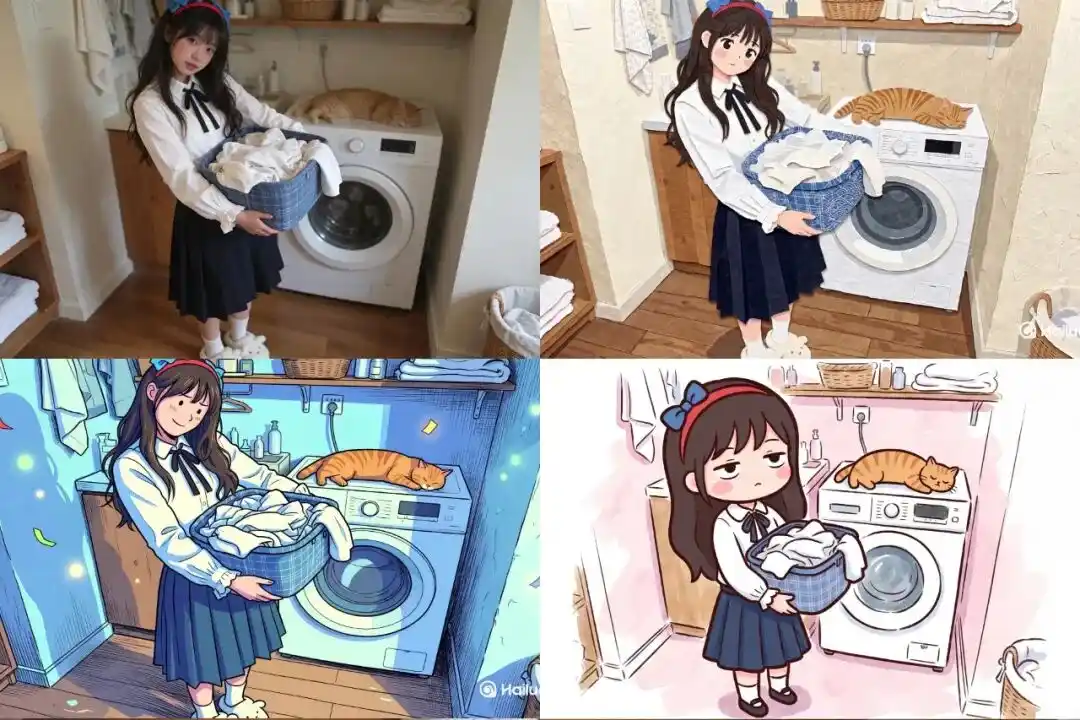
看起来效果也挺不错。
可见,
这让我们不由得期待起它的干活能力。
物理世界理解与指令遵循
上面测的大多是 AI 生成画面的真实感,下面我们要考察更硬核的东西:模型是不是真的「理解」它画的内容,这对于一些实际的设计工作来说非常重要。
在这方面,模型要对物理世界的结构和材质有正确的理解,在信息点密集时能组织清楚,并能准确遵循指令进行调整。
上来先尝试个高难度的:让
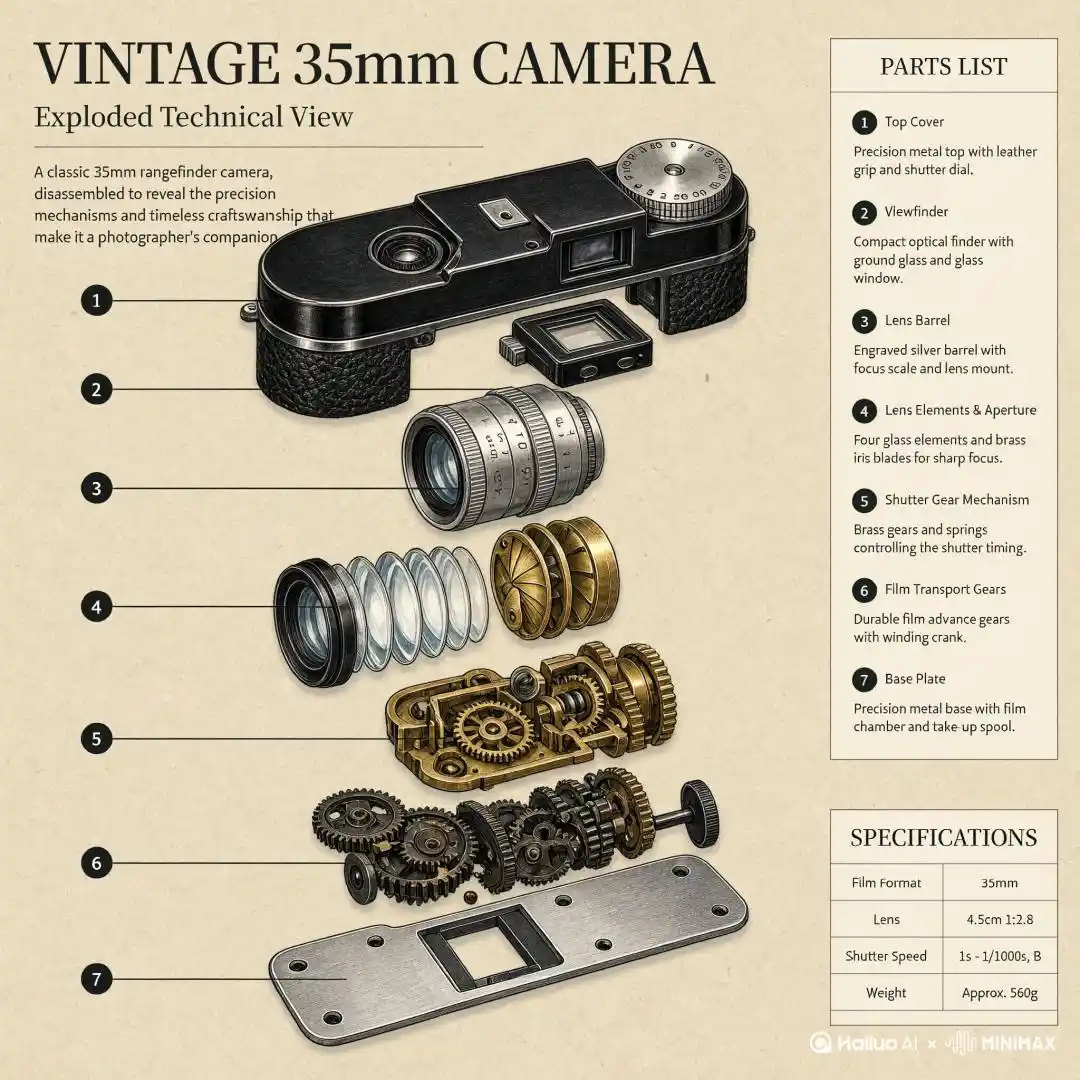
提示词:请生成一张复古风格的技术信息图海报。一台经典 35mm 旁轴相机的爆炸分解视图,16:9 横版排版,温暖的奶油米白纯色背景。七个相机部件沿中轴垂直悬浮、精确对齐、层间留白:带黑色荔枝纹皮革和金属转盘的顶盖、小型取景器、刻有距离刻度的银色镜头筒、四片玻璃镜片与黄铜光圈组件、黄铜快门齿轮机构、深色胶片传输齿轮组及摇柄、金属底板。每个部件用细引出线连接黑色圆形编号标签(白色数字 1–7)。左上角:大号衬线字体标题 "VINTAGE 35mm CAMERA",副标题 "Exploded Technical View",一条细分隔线和小号说明文字。右侧两个细线边框面板:"PARTS LIST" 包含七个编号条目(粗体名称 + 灰色说明文字字),"SP
可见它生成的图片中机身、镜头、齿轮等零件逐层拆开,编号标注、英文说明和参数表也一并生成,整体几乎达到产品说明书配图的水准。
或者上传一张服装平铺图,H3 Image 就能生成高度准确的真人穿搭照片,时尚博主的饭碗也要被「抢」了。
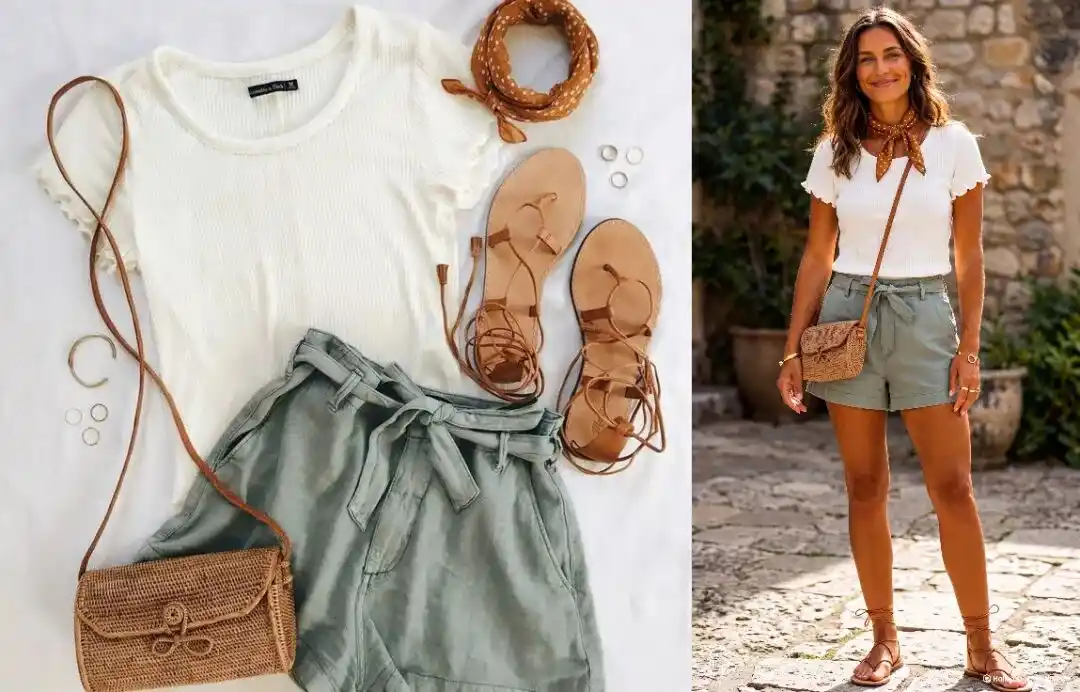
提示词:show woman wearing the outfit.
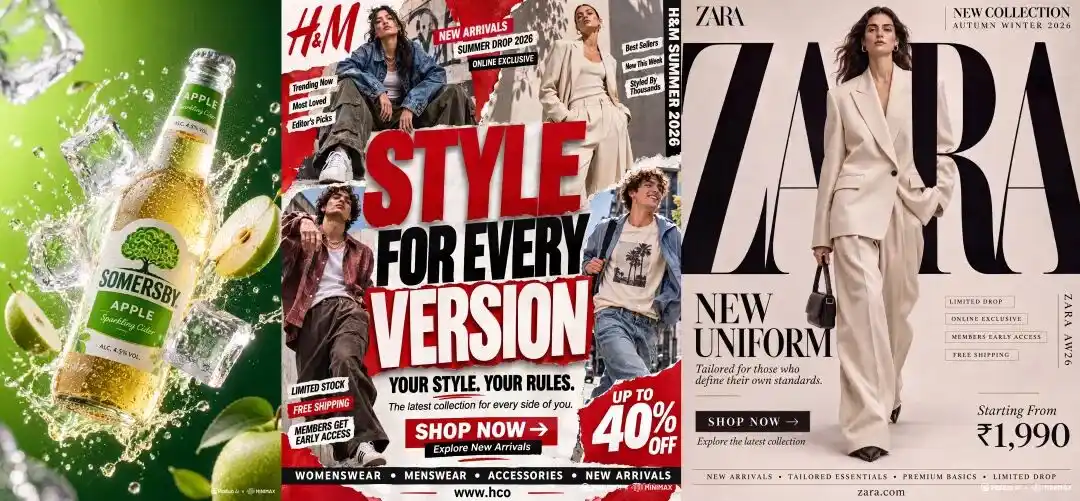
电商则是 AI 图像生成最具落地价值的场景之一。
如今,不少商家已经开始用 AI 制作商品主图、详情页和营销海报,但真正考验模型的,是能否同时兼顾商品质感、品牌信息和视觉构图,让不同元素在同一张画面中互不打架。
H3 Image 生成的物料,商品主体突出,材质、包装和细节经得起放大,周围装饰元素也与产品卖点形成呼应。在多层文字排版上,品牌标题、产品名称、促销信息之间形成了清晰的视觉层级。
平面设计方面,我们要的效果不仅有美感,还有海报文字的准确,一条提示词塞进十几个信息点会不会乱?我们让模型制作一张东方山茶花主题海报,同时处理主标题字体设计、中英文文案、花卉构图和文字排版,「山间花序」的错位穿插与花瓣融合,文案层级分明:
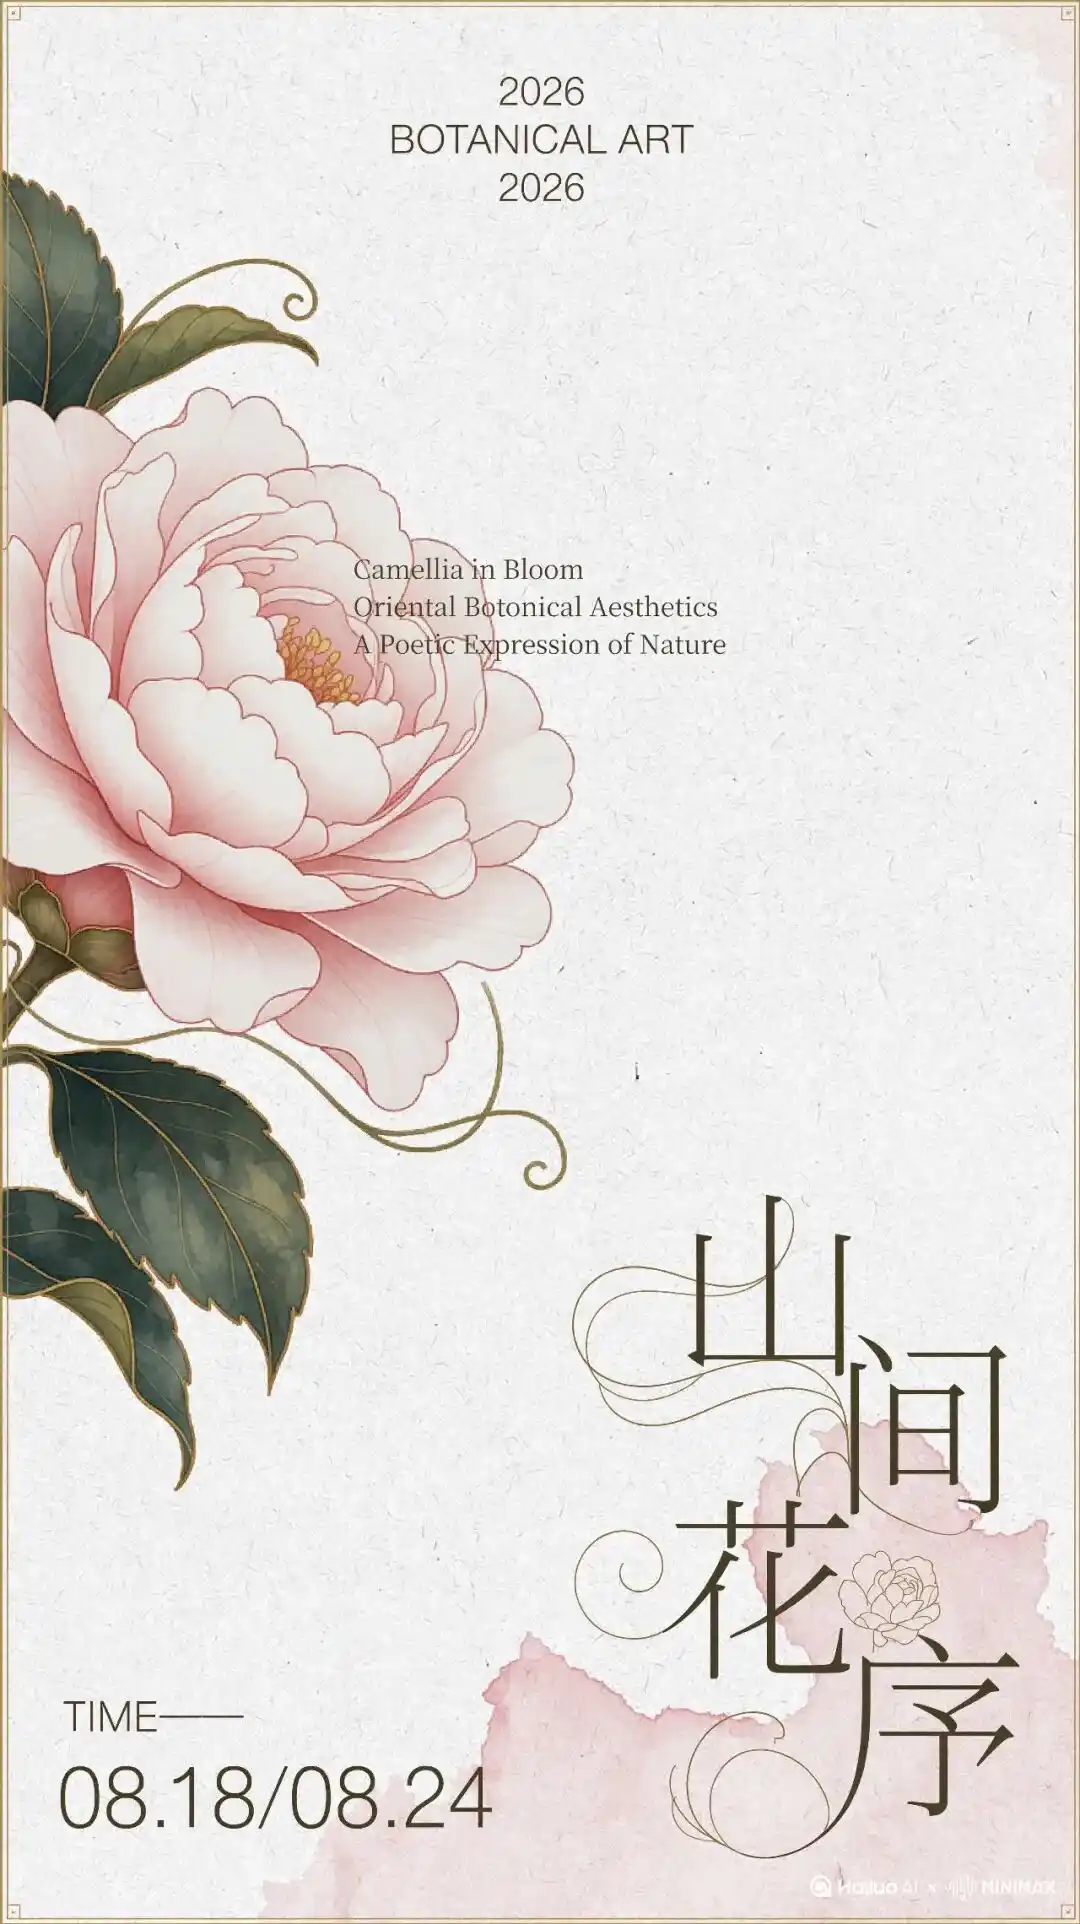
提示词:极简古典美学,高级排版海报,东方山茶花艺术,细腻花瓣纹理,白色到淡粉色渐变效果,艺术概念风格,视觉清雅且充满东方古典感;画面右下角放主题字:主题字进行字体设计,极细宋体风格「山间花序」,文字进行错位穿插摆放,字体优雅细长,笔画尾部添加花体曲线,在文字间自然穿插,整体呈现东方诗意,探索自然花卉与微观植物世界的艺术化表达;画面上方小文案依次放「2026」「BOTANICAL ART」「2026」,下方左边文案突出时间数字「TIME——08.18/08.24」,画面中融入小小字英文「Camellia in Bloom」「Oriental Botanical Aesthetics」「A Poetic Expression of Nature」。
最后检查一下H3 Image 对于指令遵循的能力。对于很多人来说,日常工作使用最多的场景就是图像编辑,增、删、改、替几乎是基操,这些都是明确的语义操作。
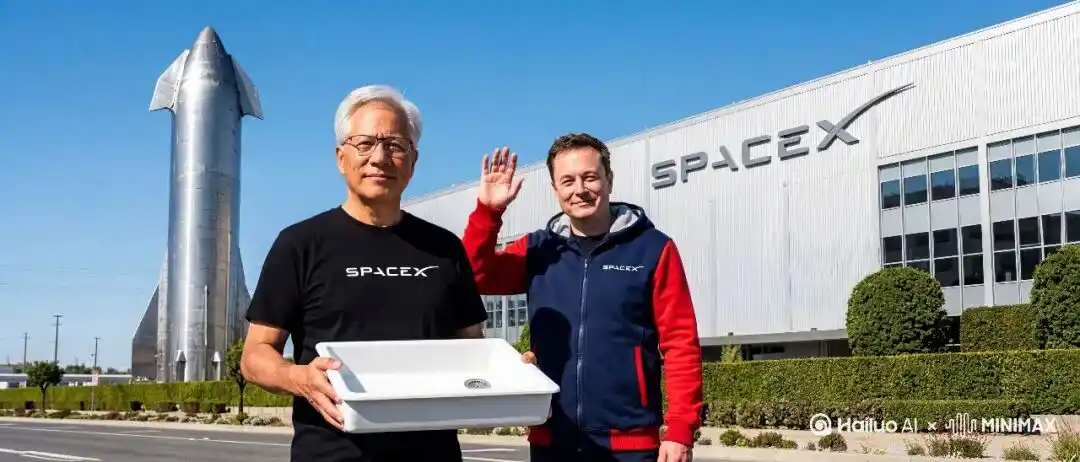
想了一想,今天好像马斯克发推对于有「机会招聘黄仁勋」表示「很荣幸」。我们试想一下这个场景:老黄拿着 Sink 在 SpaceX 大门前得到了马斯克的欢迎,生成这个画面需要一串指令,还有好几张参考图:
就这么火速加盟了。
一圈测下来,
看完实测效果,我们开始好奇
视频模型怎么成了生图 SOTA?
和市面上大多数生图模型不太一样,H3 Image 是基于
H3 Image 沿用了 H3-Base 的整体设计,拿掉音频分支并保留骨干网络、文本编码器等架构,文本一侧,其直接使用 H3 的文本编码器,这是一个 320 亿参数的多模态语言模型,负责对复杂指令、长描述和多条件逻辑的理解;图像一侧,参考图会同时进入两个模块:文本编码器负责理解「这张图里有什么」,图像 VAE 则负责把像素压缩成生成模型可以处理的视觉潜变量。
接下来是 H3 Image 的核心骨干:一个 331 亿参数的扩散 Transformer(DiT),沿用了与 H3 Omni Transformer 相同的三维多模态旋转位置编码。文本 token、参考图 token 被打包成一条完整序列,以单流方式喂进这个网络,直接预测目标图像的潜变量,最后由 VAE 解码成图。
在分辨率上,H3 Image 选择原生直出,不外挂任何超分模块,一个 checkpoint 直接生成约 1600 万像素的图像,覆盖从 4096×4096 到 21:9 的 6272×2688 等各种比例。
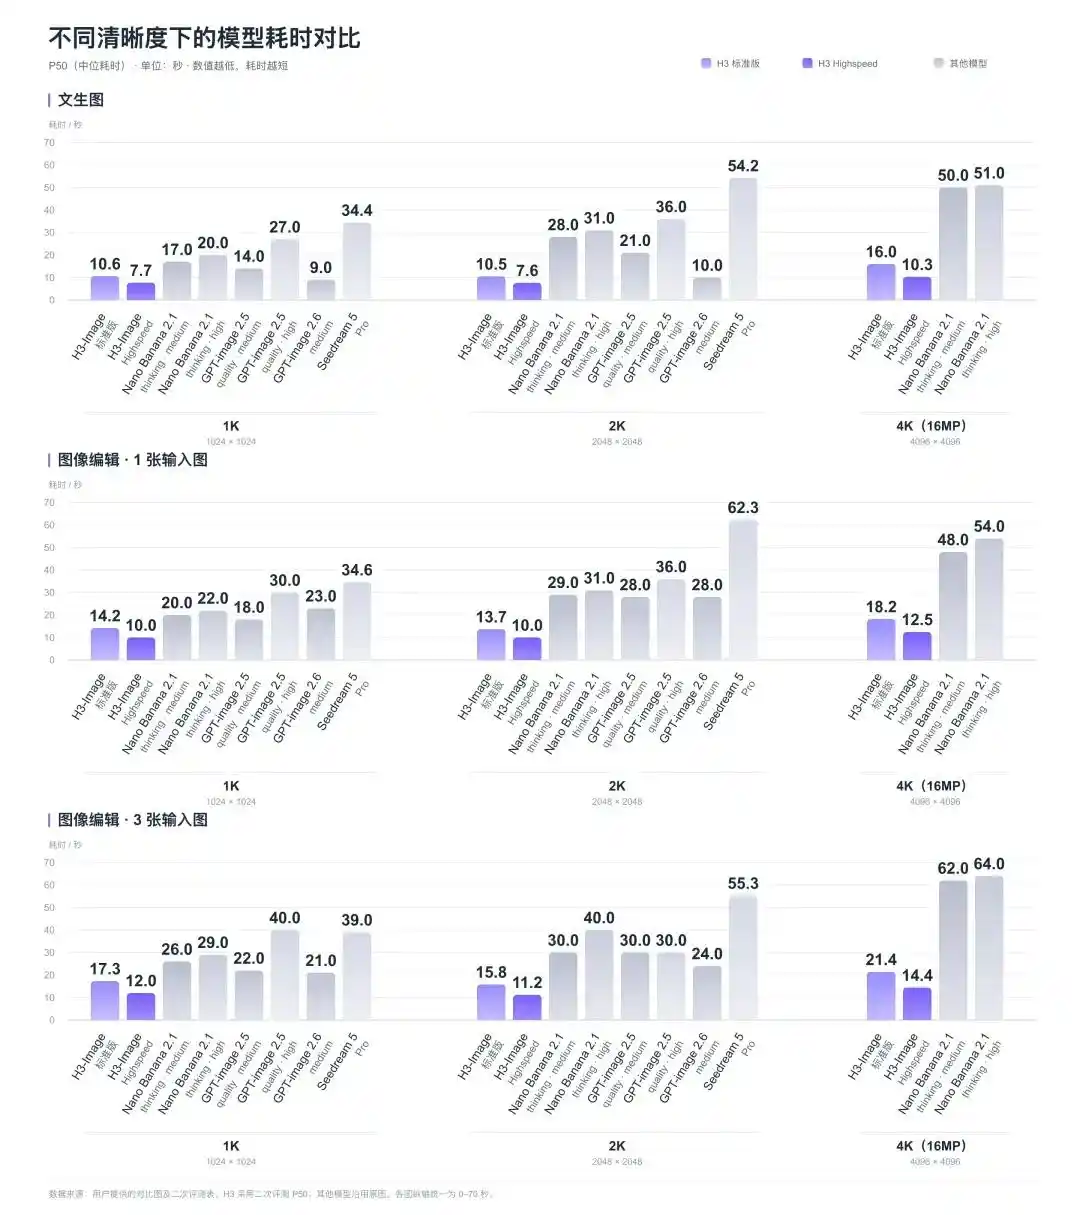
H3 Image 也具备很快的出图速度:4K 文生图的 P50 中位耗时,极速版约 10.3 秒、标准版约 16 秒,而同档对比模型普遍在 50 秒开外。
全球 AI 生态,正在依赖国产开源
如今 AI 技术的发展越来越快,新模型能力突然长出一大截,似乎也不是总要「震惊瘫坐」。这次真让我们发出感叹的其实是
如今
其实在 H3 Image 之前,海外出现了一个叫 P-H3-Image 的图像生成模型。
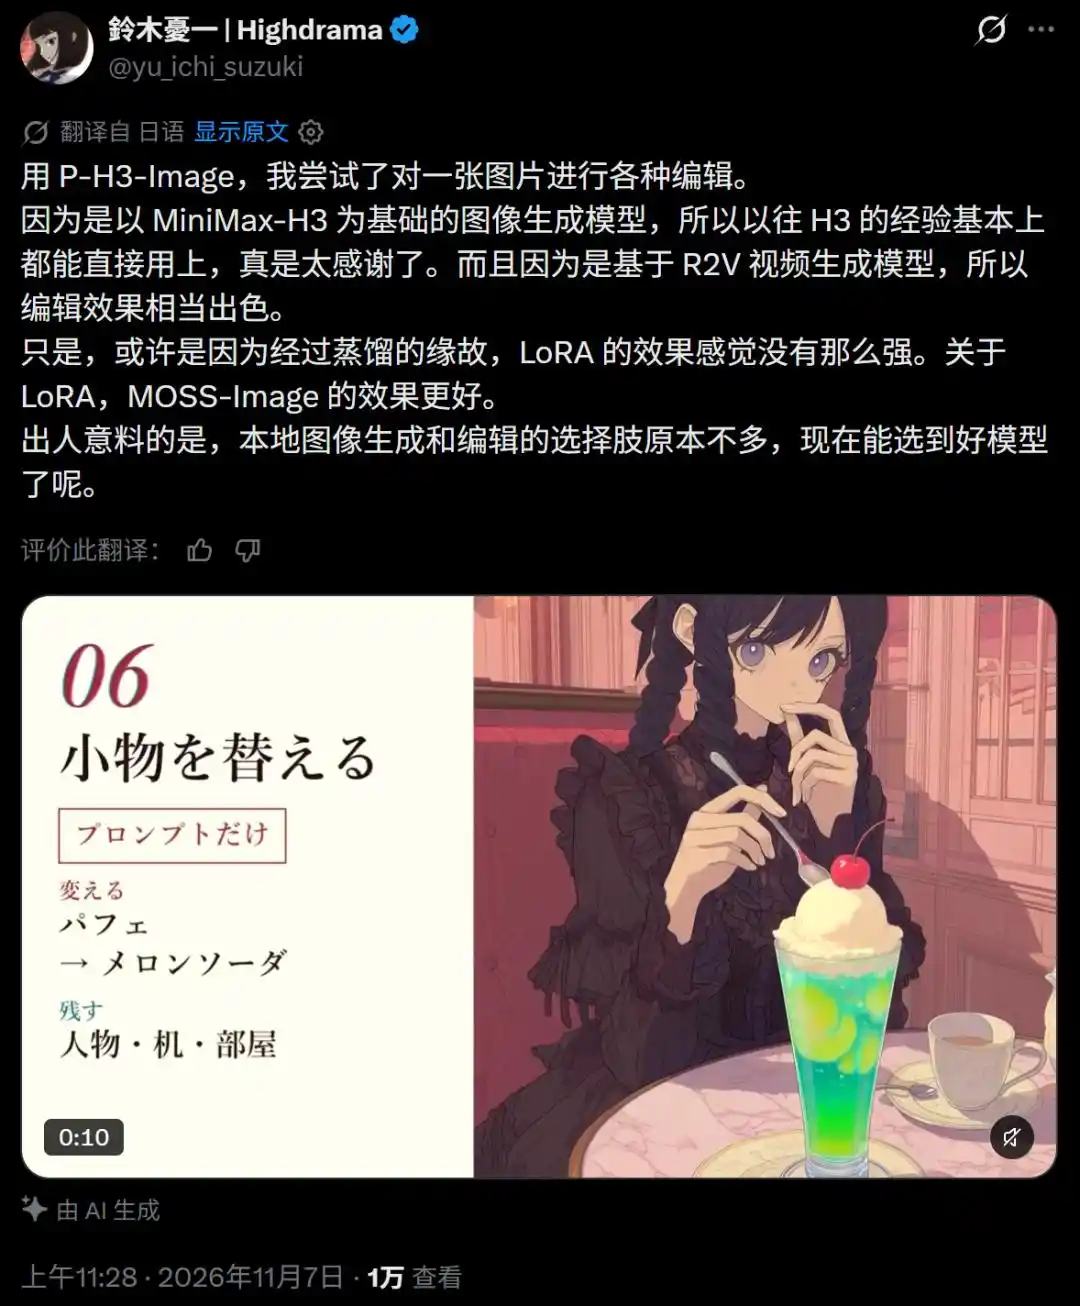
这是一个开源的图像生成模型,一家创业公司 Pruna 也是把
现在 H3 Image 发布,「正版来了」。
其实在
围绕
国内领先的开源技术,已经成为了海外团队的优先选择。
商业模式也正在这套生态系统里逐渐成型。通过免费权重占据生态位,
回看这一周,图像生成模型的能力边界几天就被重画一次,但真正决定长期格局的或许已不是跑分的高低,开源生态正在定义能力扩散的广度。当 4K 生成、十几张参考图这些前沿能力变得人人可用,竞争的内核已经从谁的模型更强,悄悄变成了「谁的生态更好」。
下一个 AI 生成新突破,或许就诞生在某个下载 H3 Image 权重的开发者手里。
本文来自微信公众号“机器之心”(ID:almosthuman2014),作者:泽南、杨文
本内容旨在传递行业动态,不构成投资建议或承诺。


24H热门新闻
暂无内容
