






DeepSeek卖“全家桶”,开发者还需要专业工具吗?
第四波科技热度: 3750
DeepSeek推出集成联网搜索、文件解析、OCR、语音识别与合成等能力的‘全家桶’API,面向开发者提供一体化AI工具服务,同时其模型也被阿里云百炼、豆包工作等平台接入。文章探讨了大模型厂商向工具层延伸的趋势,以及专业工具商在特定场景(如动态网页渲染、企业私域知识处理)中仍具不可替代性。
 摘要由 Mars AI 生成
本摘要由 Mars AI 模型生成,其生成内容的准确性、完整性还处于迭代更新阶段。
近日,
此前,阿里云百炼提供
一位支付领域的开发者对第四波表示,阿里云、腾讯云、火山引擎等厂商本来就是平台,提供不同模型和工具,是现有业务的延伸。在他看来,
1/ DeepSeek卖工具,其他平台卖DeepSeek
10月17日,
目前,V4.1 Flash已在Messages、Responses和Chat Completions三种接口下支持联网搜索、文件输入、阅读链接等功能。
开发者开启联网搜索工具后,模型可以根据问题自行搜索网页,并在回答中附上引用;开启深度思考模式后,还能在多步推理中反复搜索、阅读网页。上传PDF、Word、PowerPoint文档或图片后,模型也能提取内容并进行分析。
搜索、阅读网页等工具的执行和相关上下文处理由
价格上,
模型Token费用另计。以V4.1 Flash为例,非缓存输入每百万Token收费1至2元,输出每百万Token收费4至8元,按忙时、闲时区分。如果一个任务需要反复搜索、抓取网页和推理,实际费用还取决于各项服务的调用次数及Token消耗。
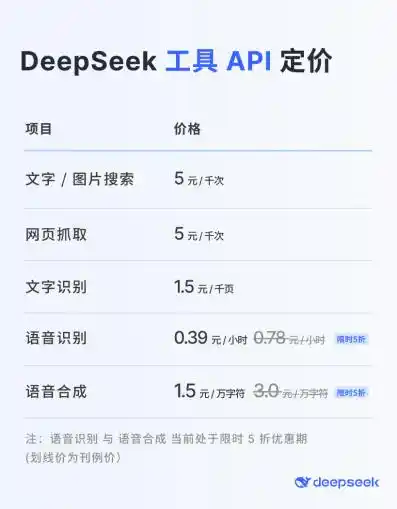
(图源:
把模型与搜索、文件等工具放在一起提供,
在国内,阿里云百炼、
例如,阿里云百炼已支持
以百炼华北2(北京)地域的Responses API调用为例,联网搜索按agent策略每千次4元计费,模型Token另计。这个搜索单价低于
面向终端用户的
此前,第三方模型调用能力已先向团队和企业订阅客户开放。企业可以通过
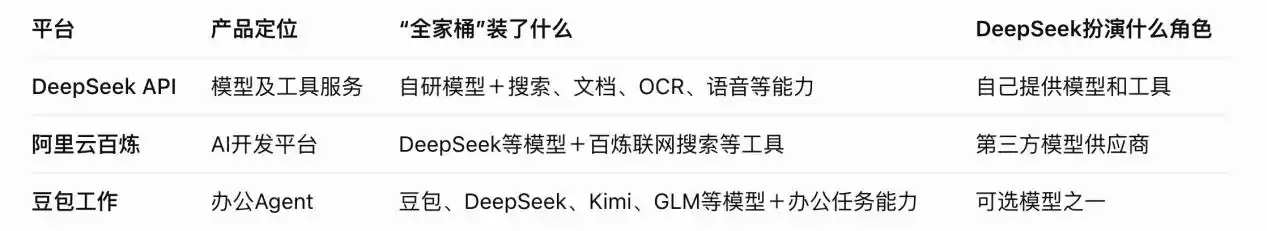
(根据
上述业内人士还提出另一种可能:“基模以外的模型和工具生态,本质上是真实场景的数据收集器。”在他的分析中,搜索请求可以反映用户正在寻找什么信息,OCR需求可以反映实际处理的文件类型。这些需求信号,很难单纯从公开语料中获得。
他认为,了解真实场景中的需求,也可能是模型厂商扩展工具服务的一层考虑。不过,这属于对业务动机的分析,并不能据此判断
2/能否替代专业工具 还要看具体任务
“全家桶”能省去多少开发工作,最终还要看工具能否完成任务。
11月14日,开发者“程序员鱼皮”发布了
Firecrawl主要向开发者提供网页搜索、抓取、整站爬取等服务,也支持动态网页渲染和浏览器交互。
据他披露,测试使用了3个搜索词和4个网址。在这组有限样本中,
不过,遇到需要JavaScript动态渲染的网页时,
文件解析方面,他上传了一份35页、包含大量图片的PDF。
测试后,他选择将普通中文搜索交给
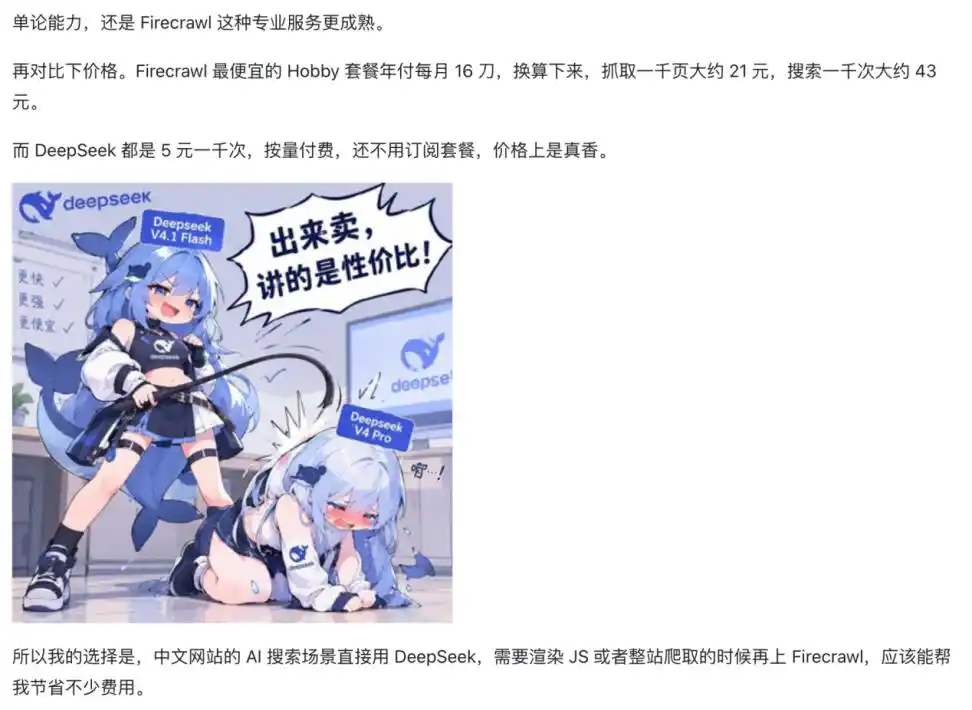
(图源:程序员鱼皮;图中Firecrawl价格为作者按套餐折算)
谈及“全家桶”对专业工具商的冲击,前述业内人士认为,客户选择工具时,未必首先考虑价格。按照他的观察,当前大多数客户仍处于验证阶段,采购决策的优先级是“可行性→省事→低价”:先确认能跑通,再比较使用体验和成本。
对于独立AI工具商,他认为“独立AI工具服务商本身不具备壁垒”,不断被基础模型覆盖是这个赛道的“内生属性”。
但并非所有专业服务都容易被基础模型覆盖。他指出,企业私域知识的处理服务就比较特殊。难点不只在于搜索和检索能力,还涉及访问权限、企业内部口径及组织中的隐性规则。相关信息本来就不在公开可索引的范围内,模型搜索能力再强,也未必能够直接解决。
(图源:Firecrawl官网)
专业工具商也在扩展服务。11月12日,也就是
开发者不一定会彻底放弃专业工具,但原本需要单独采购的一部分服务,现在有了“全家桶”更省事的选择。对
本内容旨在传递行业动态,不构成投资建议或承诺。


24H热门新闻
暂无内容
