







本地版Jev 1G内存就能跑,四舍五入等于不要钱啊
量子位热度: 4482
文章介绍开源决策模型Laya的轻量化本地部署版本Laya-MLX,该模型基于Apple MLX框架实现,仅需约700MB内存即可在Mac设备上运行,支持多语言,专注choice/score/noul三类结构化决策任务,推理速度快、端到端延迟低至7.39ms,无需云端API或PyTorch依赖。
 摘要由 Mars AI 生成
本摘要由 Mars AI 模型生成,其生成内容的准确性、完整性还处于迭代更新阶段。
不是,Jev才刚火一周,1GB不到的本地版都给整出来了???
有开发者把开源平替Laya原生搬上Apple MLX,做出了Laya-MLX——
421M参数版本,峰值MLX内存占用只有943.6MiB。
换成322M的多语言版本,更是直接掉到了687.6MiB。
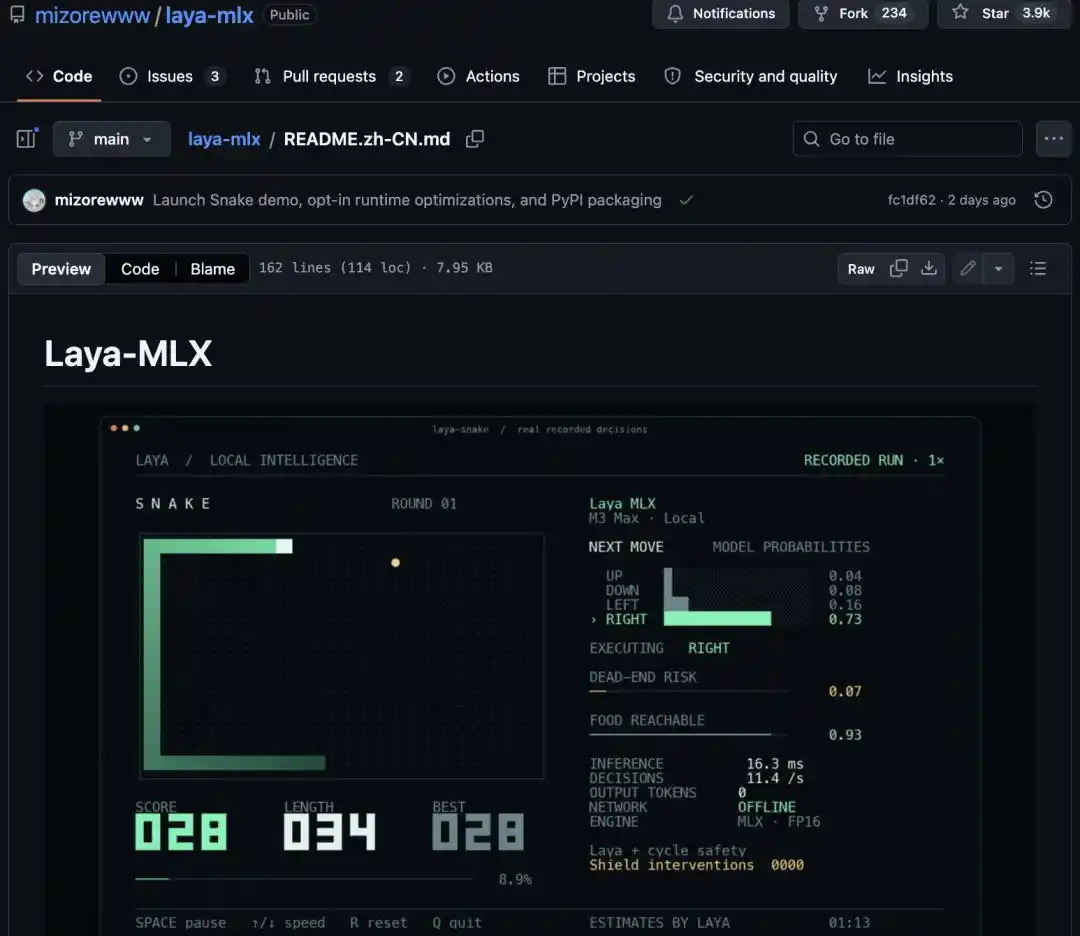
不走云端API,不需要PyTorch和Transformers runtime,模型下到Mac里就能直接跑。
而且小归小,速度还挺猛。
在M3 Max上,Laya-MLX一个短决策P50最快只要7.39ms;421M版本也只有13.42ms。
如果一次塞进去50个问题,322M多语言版本的吞吐还能冲到395 questions/s。
开源版Jev
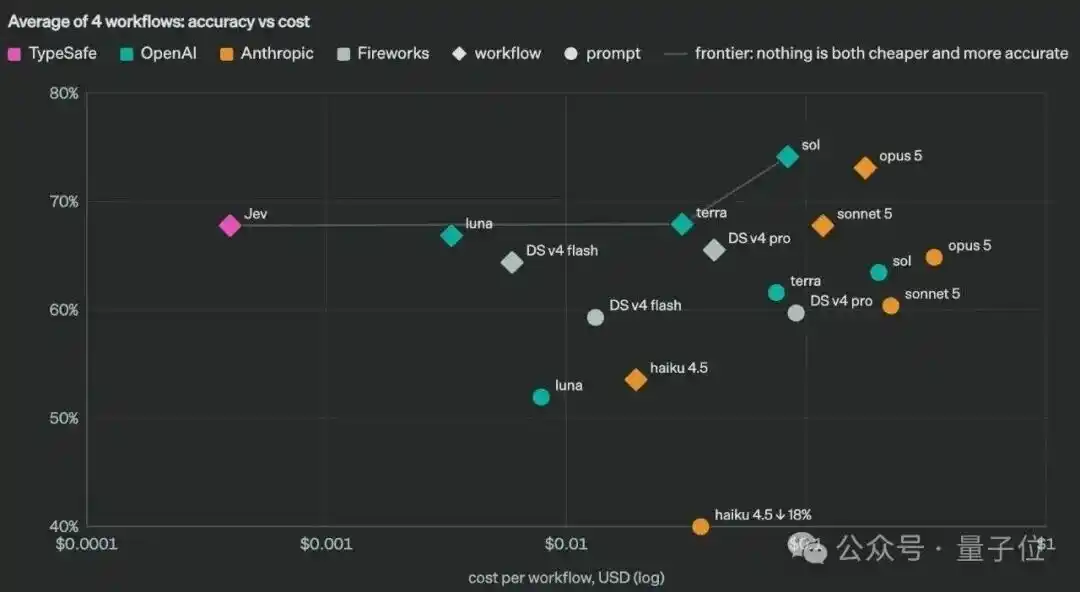
Jev大家这两天应该已经眼熟了。
它和普通LLM最大的区别,就是直接把最耗时间的文本生成砍了,聊天不会,代码不写,文章也不碰……只专心干一件事,下判断。
(Bert:嗯?这个工作内容我好像在哪里听过?)
少了逐Token生成这一步,推理速度自然和传统LLM拉开了差距。
也就是靠着这种简单粗暴的玩法,Jev发布之后迅速出圈。
紧接着,开源平替就来了。
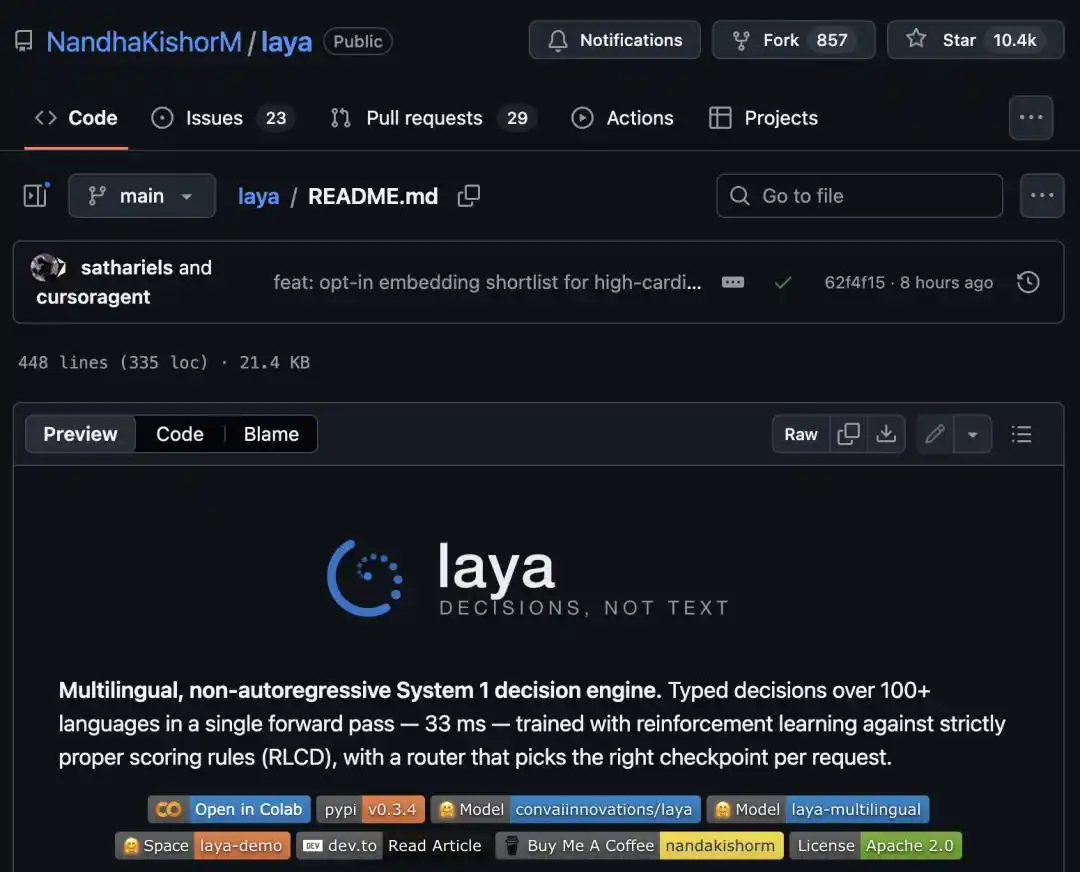
Laya,一个多语言、非自回归的System 1决策模型。
思路和Jev类似,同样不把算力花在生成文本上,直接针对结构化问题输出决策结果,在GitHub已经狂揽10.4k Star。
它目前主要就干三类活:
choice,从几个选项里挑一个;score,按照给定标准打分;noul,判断一件事情为True的概率。
把一段state和需要判断的问题一起塞进去,一次forward直接能得到结果。
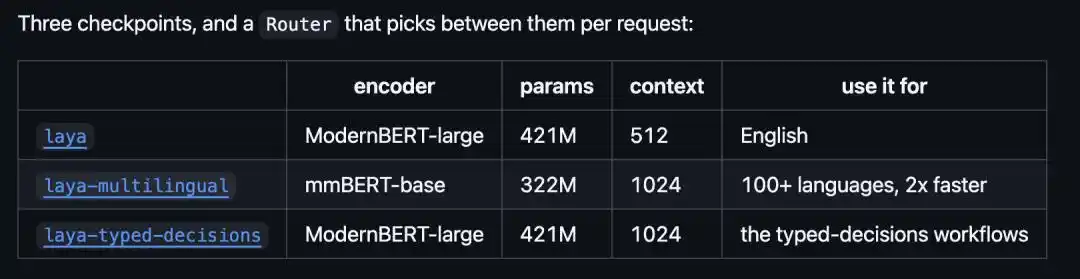
Laya目前主要有三个checkpoint。
英文版本基于ModernBERT-large,421M参数;
多语言版本基于mmBERT-base,只有322M参数,支持100多种语言;
另外还有一个针对typed-decisions工作流的421M版本。
模型本身就只有三四亿参数,速度也已经相当快。
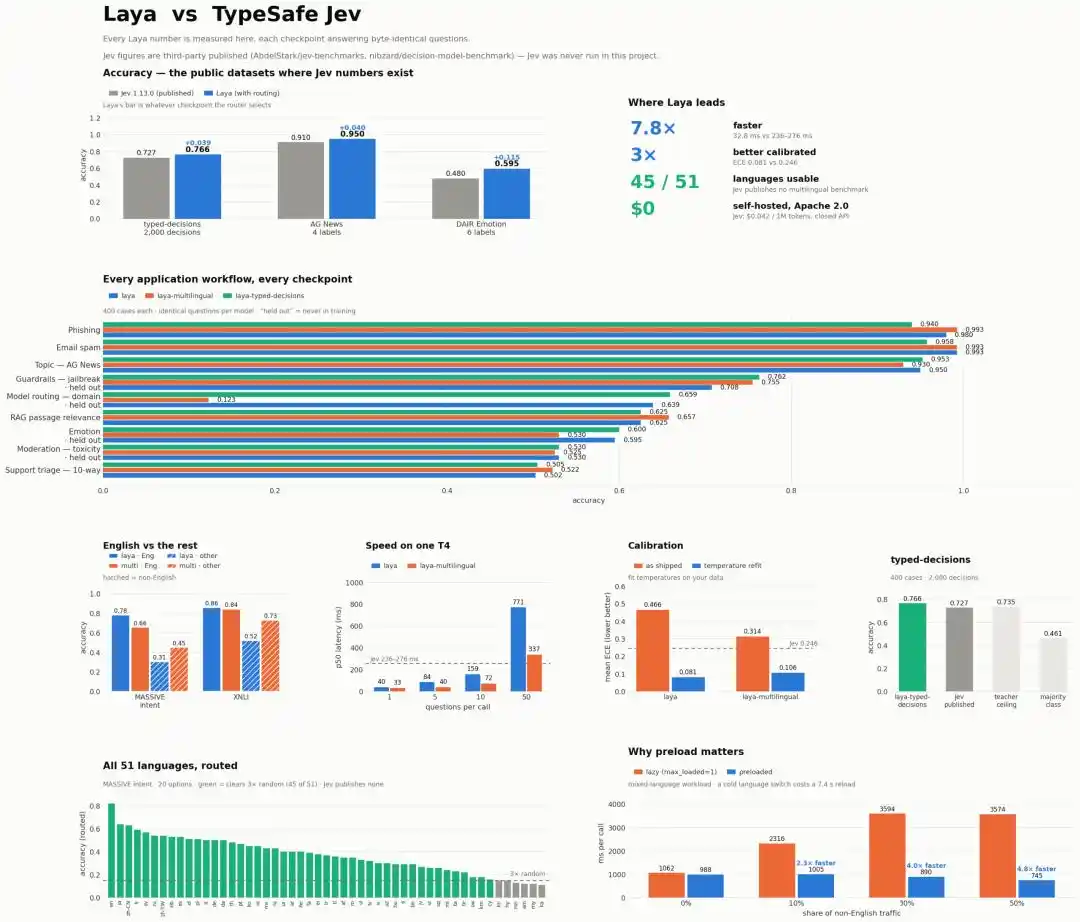
原版Laya在Tesla T4上,单个问题大约33ms;批量处理时平均可以做到7.2ms/question,单卡吞吐量最高达到数百个问题每秒。
项目引用的第三方Jev P50延迟在236~276ms,而Laya自己测得单问题为32.8ms,大约快7~8倍。
在yped-decisions的2000次决策测试中,专门微调过的Laya版本准确率为76.6%(之前Jev公开成绩是72.7%)。
开源版有了,速度也不慢。
紧接着就有人开始琢磨,还能不能再小一点?
于是Laya-MLX来了。
本地1GB可跑
Laya-MLX动的是Laya的推理栈。
开发者已经能够自己部署原版Laya,但主要跑在PyTorch、Transformers这套环境里。
mizorewww则在Apple MLX框架上重新实现了Laya完整神经网络架构,让模型能够原生跑在Apple Silicon上。
PyTorch和Transformers runtime都可以拿掉,也不需要请求云端API。
而且换了推理栈之后,原来的结果也得对得上。
Laya-MLX把三个checkpoint分别用FP32和FP16进行了验证,在63个验证问题上,全部匹配原版Laya选择的答案。
三个模型、两种精度,一共378/378次对比通过,没有出现推理结果漂移。
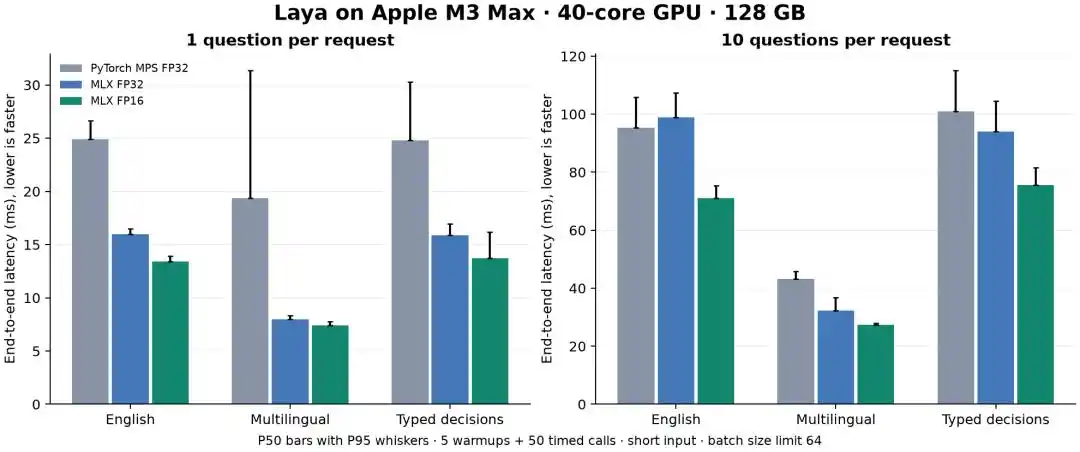
测试机器是一台M3 Max,40核GPU、128GB统一内存。
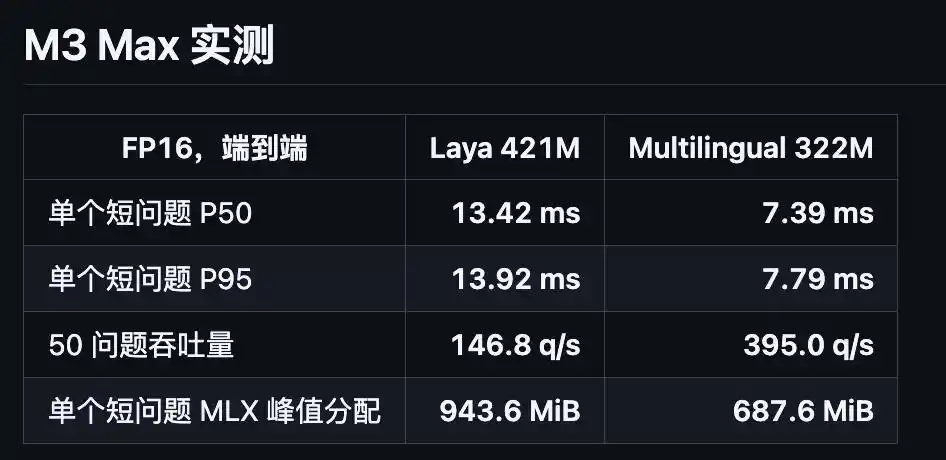
421M英文版本处理一个短问题时,峰值MLX allocation为943.6MiB;322M多语言版本进一步降到687.6MiB。
但速度没有跟着缩水。
同一台M3 Max上,421M版本处理一个短问题,P50延迟为13.42ms;322M多语言版本为7.39ms。
P95也分别只有13.92ms和7.79ms。
如果一次塞50个问题进去,多语言版本吞吐可以直接冲到395 questions/s。
而且这些时间还不是模型核心算子的裸延迟。
项目的计时范围包含了prompt准备、tokenization、tensor构建、同步推理、校准以及最终结果格式化,只把模型加载时间排除在外。
换句话说,7.39ms测的是一次短决策从进去到结果出来的端到端延迟。
Laya-MLX玩贪吃蛇游戏的决策速度可以达到每秒60次。
这里每走一步都会实际调用一次Laya,根据当前状态重新做决策,外面再由cycle safety layer对危险动作进行纠正。
打开项目测试过的编译和prefix reuse优化后,在同一台M3 Max上连续跑2400步——
75.40 moves/s,0次死亡。
整个过程中,安全层可见介入了2次,仅少量场景做了动作修正。
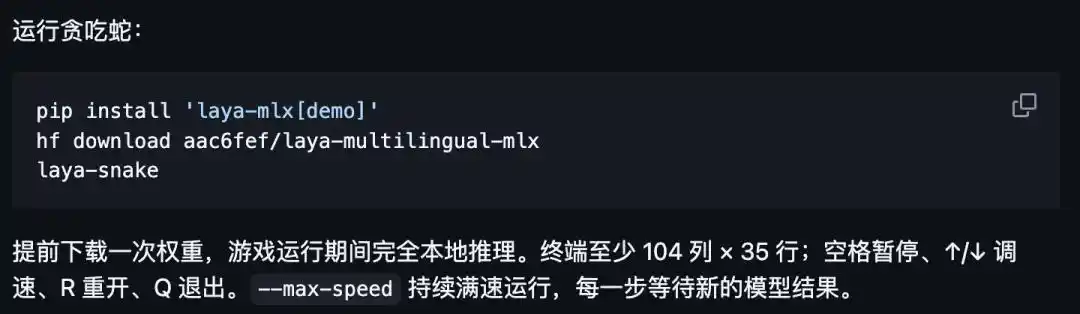
三行运行
感兴趣的朋友可以直接在Apple Silicon Mac上本地部署。
目前项目要求Python 3.11+、macOS 14+。
安装依赖后,可以直接导入库使用,加载已经转换好的checkpoint:
pip install laya-mlximport laya_mlx as layaagent = laya.load(“aac6fef/laya-mlx”)
接下来把state和问题交给agent.predict()就行。
第一次运行会自动下载checkpoint,之后的推理就可以完全留在本地。
当然了,小也有小的代价。
421M英文版本上下文只有512 tokens;
322M多语言版和421M typed-decisions版本,也只有1024 tokens。
1k上下文还需要同时容纳state、instructions和options,所以它更适合短输入、高频调用、输出结构明确的决策任务。
短板客观存在,但挡不住开源大佬连夜跟进,没错咱已经在dream下一版了!
Jev:我才刚火了一周。。。
项目地址:https://github.com/mizorewww/laya-mlx
本文来自微信公众号“量子位”,作者:闻乐
本内容旨在传递行业动态,不构成投资建议或承诺。


24H热门新闻
暂无内容
