扫描下载APP
其它方式登录
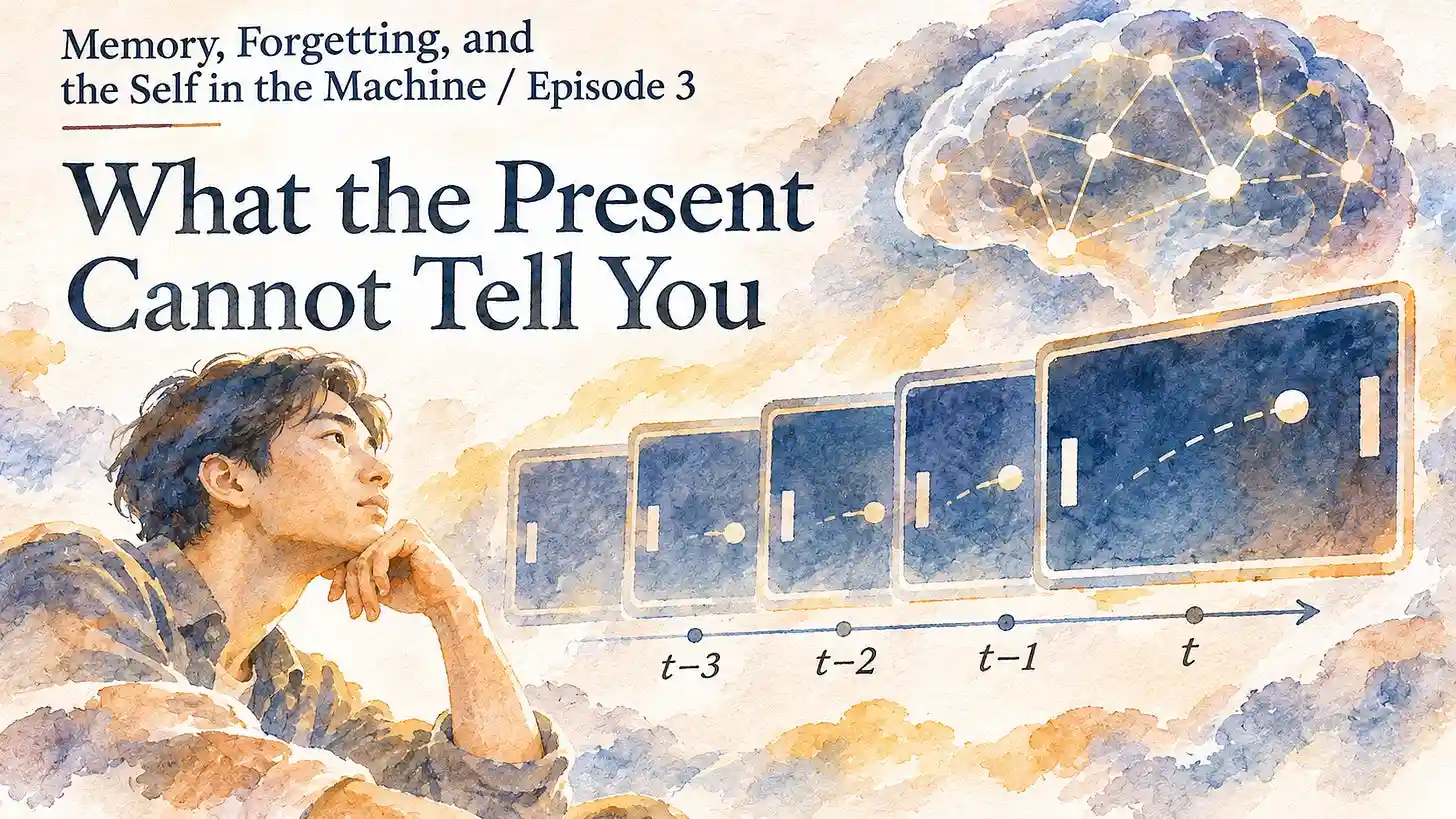
文章探讨人工智能在时序决策中的根本局限:大模型虽能存储海量静态知识,却受限于算力与上下文窗口,无法持久保留动态交互中的完整历史;以Pong游戏和DQN智能体为例,揭示‘观测值’与‘系统状态’的割裂,以及固定帧堆叠(如4帧)作为记忆折中方案的物理边界与信息损耗本质。
文章介绍由卡马克与萨顿团队研发的Physical Atari系统,通过低成本机械手在真实环境中直接操作Atari游戏摇杆,实现强化学习算法在真实世界中的长时间自主学习,验证了‘实时强化学习’的可行性,并揭示了机器人本体差异对策略迁移的关键影响。