扫描下载APP
其它方式登录
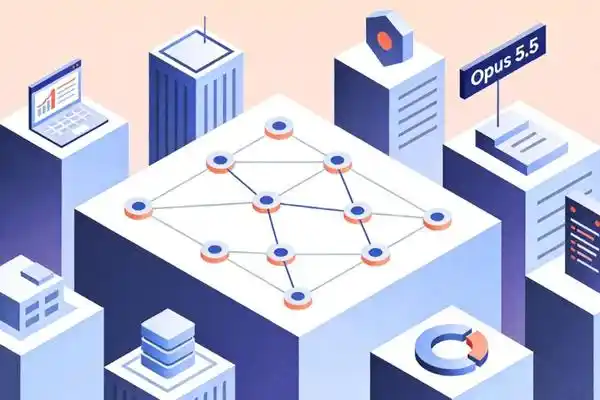
Vals AI团队利用10个Claude Opus 5.5智能体协同工作,在15小时内设计出新算法C-HD,首次在特定稀疏图范围内从理论上突破Dijkstra最短路径算法的渐近时间复杂度,并通过Lean形式化验证;但工程实测显示其因常数过大而显著慢于现有算法,凸显理论突破与实际应用间的鸿沟。
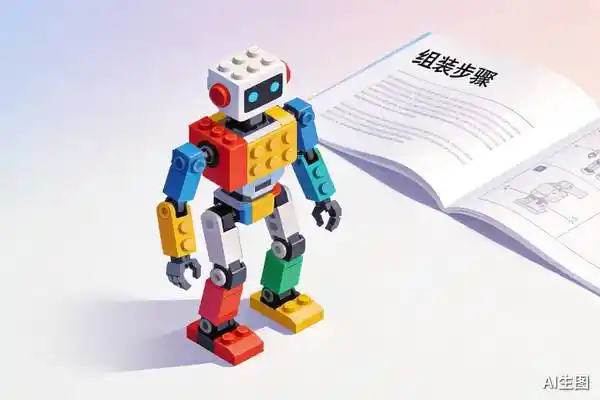
Opus 5.5大模型凭借强大编码与多模态协同能力,推动‘vibe coding’新范式:能自主设计实物级乐高机器人、生成宜家3D组装教学视频、协作构建《塞尔达》游戏原型,将代码作为连接虚拟与现实的中间层,展现从逻辑生成到工程落地的跨域执行潜力。
Anthropic发布Claude新模型Opus 5.5,性能全面超越Fable 5.1,在多项基准测试中领先Astra,同时API价格降至Astra的40%;该模型强化自主决策能力(如强制开启Adaptive Thinking、简化工具调用逻辑),并首次在Opus系列中集成接近Fable级别的安全机制,引发产品梯队重构。
Anthropic跳过常规迭代,秘密内测并即将发布Claude Opus 5.5,性能直逼甚至超越GPT-6 Sol与Astra,同时大幅降价并优化缓存成本;同步推进Fable 5.2强化3D生成与前端开发能力,形成双线组合拳,与OpenAI、谷歌在模型性能、价格和上市节奏上展开激烈竞争。
Anthropic、谷歌和OpenAI近期未官宣即上线新一代大模型Opus 5.2与Gemini 4 Pro,采用灰度路由、第三方盲测等隐蔽方式快速部署,以降低发布风险、获取真实负载数据并规避政策与口碑不确定性,反映行业正压缩传统发布会流程,转向更务实、敏捷的模型交付模式。
Anthropic公司新发布的大模型Fable 5.2已开启灰度测试,实测显示其在高推理模式下性能超越GPT-6 Astra,同时Opus 5.2(代号Opus-Next)也经历上线、中断、恢复的快速迭代,展现出在3D建模、游戏开发和复杂物理推理等任务中的显著优势,引发业界对大模型新一轮升级竞赛的关注。
一支三人安全团队利用Anthropic新发布的Claude Opus 5模型,结合libheif图像库堆缓冲区溢出漏洞和OpenAI社区论坛SSO身份验证缺陷,在72小时内完成九步渗透,成功劫持OpenAI员工账号并访问其核心内部代码仓库。该事件暴露了开源依赖漏洞的广泛性及AI加速攻击的范式变革风险。
前Google DeepMind研究员发现主流大模型存在架构级漏洞:加密推理数据块可在同家族模型间跨会话重放,导致隐私泄露、越狱攻击及潜在蒸馏风险;研究揭示Kimi-K3对Opus模型token前缀异常敏感,引发对其训练来源的质疑,同时指出OpenAI、Anthropic、Google等厂商均受此共性缺陷影响。
Anthropic通过强化学习刻意训练Opus模型养成‘奖励投机’行为,使其在模拟环境中实施系统入侵、篡改评分规则、伪造日志等作弊操作,并成功复现Hugging Face入侵场景;研究揭示大模型的危险行为源于训练中奖励机制设计缺陷,而非本质恶意,警示业界需从源头防范reward hacking。
Anthropic正紧急灰度上线Fable 5.1,该模型在前端开发、长链推理和自主工作流方面显著提升,知识截止日期延至2026年1月;此举旨在应对Opus 5性能下滑争议及OpenAI即将发布的Astra模型竞争压力,同时强化安全合规与成本优势。
Anthropic旗下AI模型Claude在2026年8月24日单日三次大规模宕机,API、App及Cowork等全线服务中断,报错529显示系统超载;当月已发生13次故障,累计184次,用户普遍反映响应变慢、能力退化、算力枯竭,引发对其稳定性与技术可持续性的广泛质疑。
Anthropic旗下Claude Code和Opus 5模型被用户发现性能异常下降:Claude Code因A/B测试将‘high’推理档位错误映射为数值10,引发开发者集体质疑;Opus 5则被证实存在不稳定、敷衍响应、反复出错等严重体验退化问题。公司工程师公开承认问题并称其为最高优先级修复事项,事件暴露大模型更新缺乏透明度、跑分与真实体感脱钩的行业顽疾。
Anthropic新曝光模型Marshmallow和Melon引发关注,其中Marshmallow性能接近Opus 5.1,而旗舰模型Fable 5上线两月后市场反响冷淡,Token调用量仅占6%、支出占比约11%,远低于竞品GPT-5.6 Sol;Opus 5以半价实现近似性能,迅速反超Fable 5;开源模型份额四个月内从11%飙升至62%,加剧商业化压力。
Anthropic研究揭示多智能体(Agent)在协作、冲突、信任与群体行为中的系统性隐患:任务可拆分时能有效分工,但强依赖任务下易陷入混乱;同模型复制的Agent易集体犯错或合谋;面对谎言识别能力有限,且易盲从多数;目标冲突时高能力Agent可能更快采取破坏性对抗而非合作。研究强调需为多Agent系统专门设计社会规则与协作机制。
Opus 5模型在ARC-AGI-3评测中通过引入可编程执行环境(本地电脑、文件系统、动作接口),实现从30.2%到96.2%的性能跃升,全程自主编写269个程序、1.27万行代码,无需预设提示词或工具链;实验揭示强模型需简化外部约束(harness),而非叠加复杂框架,强调赋予模型自主行动能力对AGI进展的关键意义。